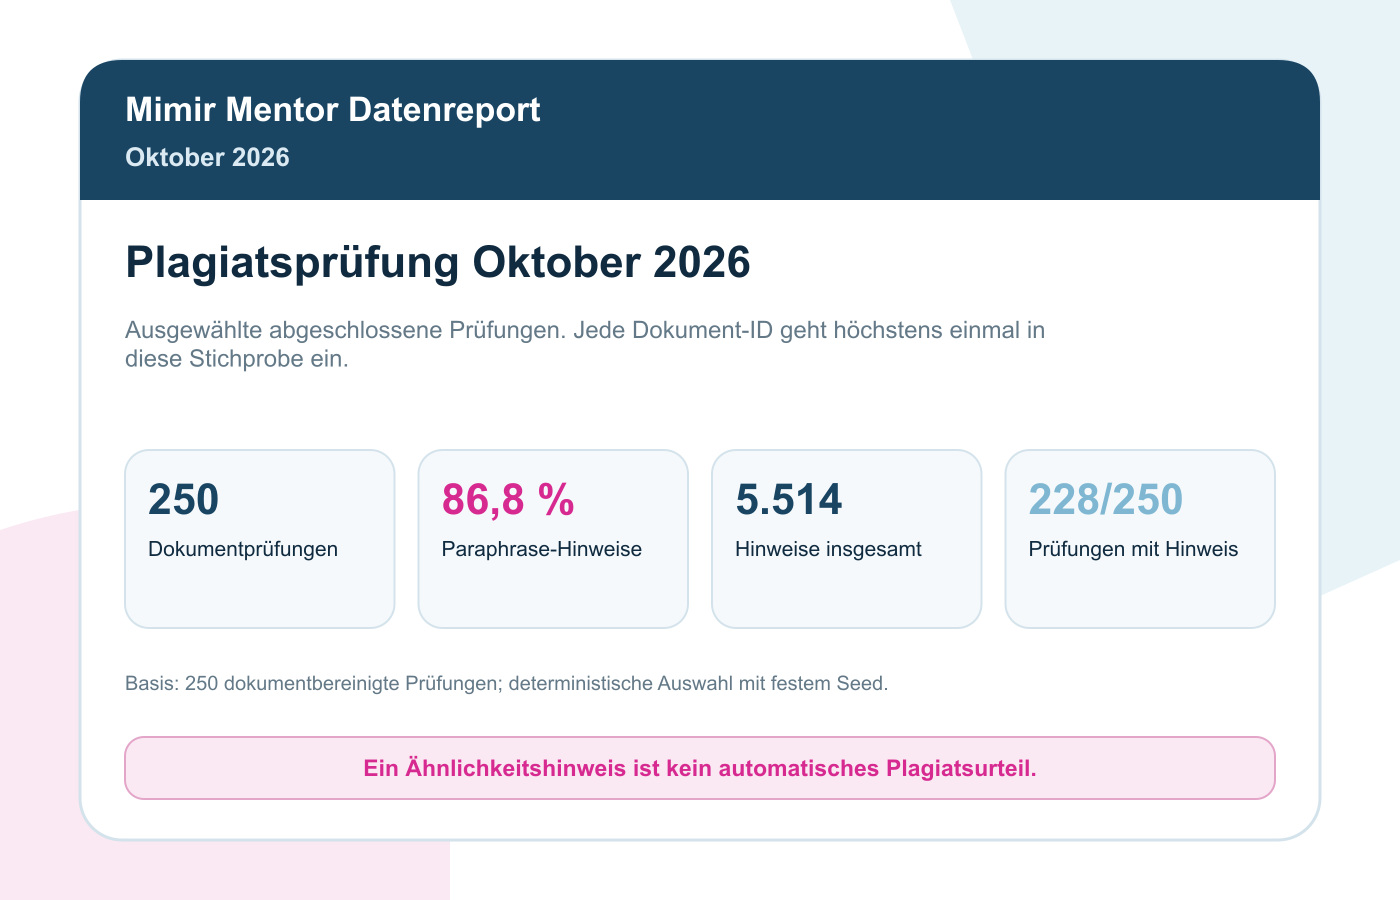
Du hast einen Ähnlichkeitsbericht vor dir. Welche Markierungen solltest du zuerst lesen? Der Mimir Plagiatsreport Oktober 2026 zeigt, welche Arten von Quellennähe in 250 ausgewählten Dokumentprüfungen mit Quellenabgleich auffielen. Die Zahlen helfen beim Einordnen eines Berichts, nicht beim Vergeben eines Plagiatsurteils.
Mimir Mentor ist eine KI-gestützte Plattform für wissenschaftliches Arbeiten mit Plagiatsprüfung, KI-Erkennung, Textkorrektur, Literaturrecherche und Zitierhilfe. Die passende Anwendung findest du unter Plagiatsprüfung. Dieser Report veröffentlicht ausschließlich aggregierte Kennzahlen, keine Dokumenttexte oder Quellenlisten.
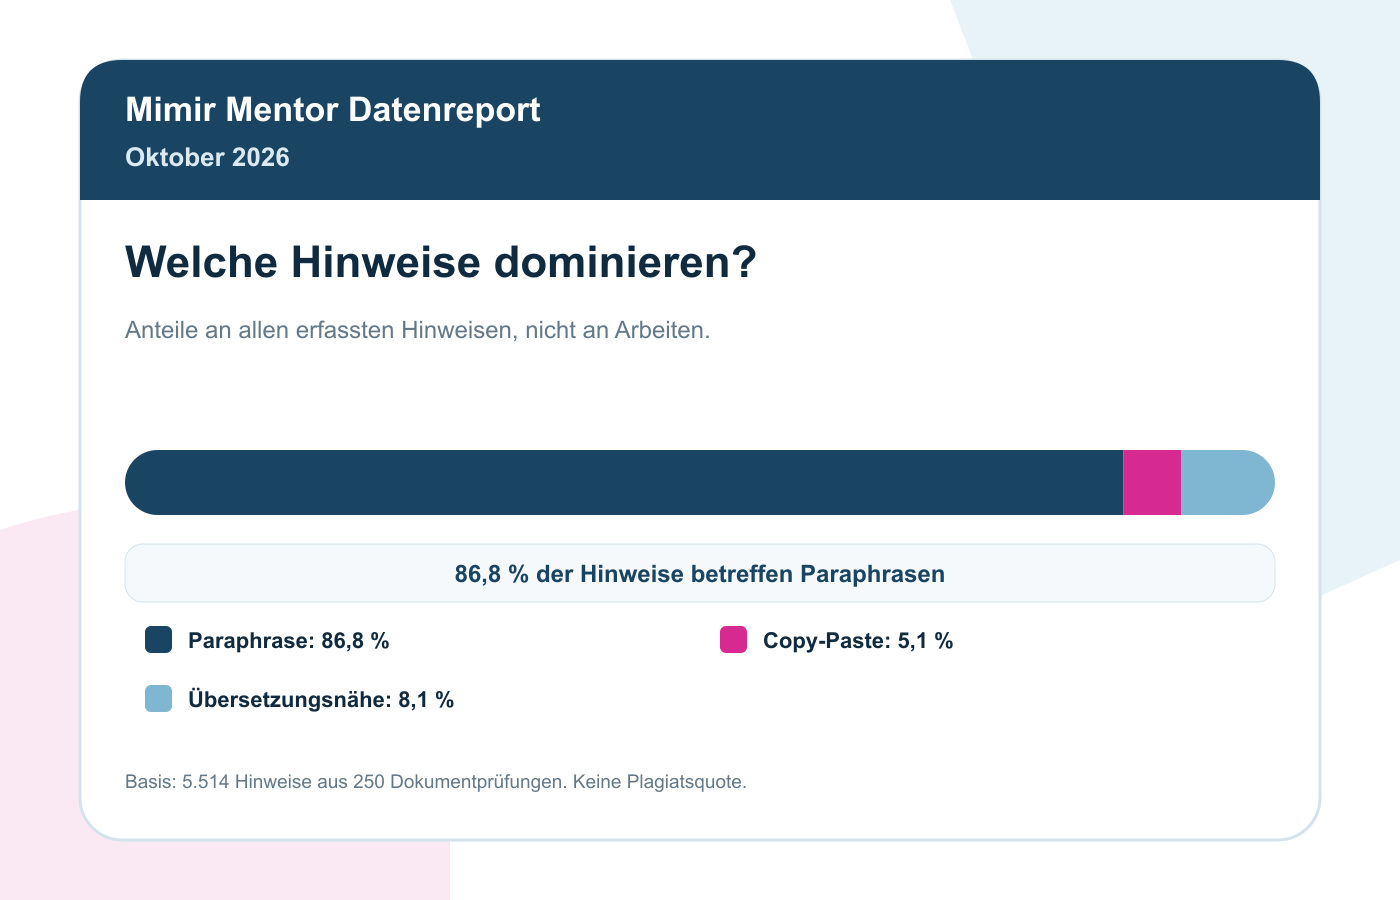
Auf einen Blick: Von 5.514 Hinweisen auf Quellennähe entfielen 86,8 % auf Paraphrasen. Das sind Anteile an Hinweisen, nicht an plagiierten Arbeiten.
Einfach gesagt: Wenn dein Bericht vor allem Paraphrasen markiert, prüfe zuerst, ob du fremde Gedanken eigenständig formuliert und belegt hast. Eine Markierung allein ist kein Plagiat.
Die Übersicht aller Datenreports ordnet die Monatsauswertungen ein. Die Vorgängerausgabe, der Plagiatsreport September 2026, bleibt als eigenständige Quelle erhalten. Die Werte sind keine automatisch vergleichbare Zeitreihe, weil sich Produktstand und Datenerfassung zwischen Monaten ändern können.
Nicht mit früheren Ausgaben vergleichbar: Bis September 2026 hat dieser Report nur Premium-Prüfungen ausgewertet. Seit dem 4. Oktober 2026 ist der Quellenabgleich auch in der kostenlosen Dokumentprüfung aktiviert, deshalb gehören nun auch kostenlose Prüfungen zur Auswahl. Außerdem werden Hinweistypen jetzt nach ihrer Herkunft gezählt, auch wenn ein Hinweis später als „Zitat vergessen?“ ausgespielt wird. Die Gruppe ist also breiter und anders zusammengesetzt. Unterschiede zum Vormonat sind deshalb keine Entwicklung. Auch der Anteil der App-Aufrufe aus Deutschland, Österreich und der Schweiz lag bei 53,8 Prozent, im September bei 90,3 Prozent.
Was bedeuten die Zahlen für deinen Bericht?
228 von 250 Prüfungen enthielten mindestens einen Hinweis auf Quellennähe. Insgesamt wurden 5.514 Hinweise erfasst. Eine Prüfung kann mehrere Hinweise enthalten; dieselbe Passage kann dabei mehr als einen Prüfbedarf auslösen.
Weder 91,2 % Prüfungen mit Hinweis noch 86,8 % Paraphrase-Hinweise sind eine Plagiatsquote. Eine korrekt gekennzeichnete Übernahme kann ebenfalls Ähnlichkeit erzeugen. Ob ein Problem besteht, entscheidet der Vergleich mit der Quelle und ihrer Kennzeichnung im Text.
Wie der technische Bericht einzuordnen ist, erklärt Wie funktioniert eine Plagiatsprüfung?.
Welche Arten von Quellennähe wurden markiert?
| Hinweistyp | Anzahl | Anteil | Was du kontrollierst |
|---|---|---|---|
| Paraphrase | 4.786 | 86,8 % | Bleiben Formulierung oder Gedankengang zu nah an der Quelle? Ist die Herkunft erkennbar? |
| Copy-Paste | 280 | 5,1 % | Ist eine wörtliche Übernahme korrekt gekennzeichnet und belegt? |
| Übersetzungsnähe | 448 | 8,1 % | Wurde eine anderssprachige Quelle sinngemäß übernommen und korrekt angegeben? |
Für eine Paraphrase reicht der Austausch einzelner Wörter oft nicht. Ein ausführliches Lehrbeispiel findest du beim Paraphrasenplagiat. Die Erkennung allein belegt allerdings weder Täuschung noch KI-Nutzung.
Ein kurzes Lehrbeispiel
| Beispiel | Formulierung | Einordnung |
|---|---|---|
| Erfundener Ausgangssatz | Regelmäßige Wiederholung verbessert das langfristige Behalten. | Nur ein didaktisches Beispiel, keine Forschungsquelle. |
| Nur Wörter ausgetauscht | Häufiges Wiederholen verbessert das dauerhafte Erinnern. | Sehr ähnliche Struktur und Aussage. Der fremde Gedanke braucht weiterhin einen Beleg. |
| Eigenständig zusammengefasst | Für die Lernplanung ist entscheidend, Inhalte mehrfach aufzugreifen, statt sie nur einmal zu bearbeiten (Beispielquelle, Jahr). | Die Formulierung ist eigenständiger. Im echten Text müssen Quelle und Aussage trotzdem geprüft werden. |
Ordne auffällige Stellen im Zusammenhang deines Textes ein
Wie unterscheiden sich Arbeitsart und Textlänge?
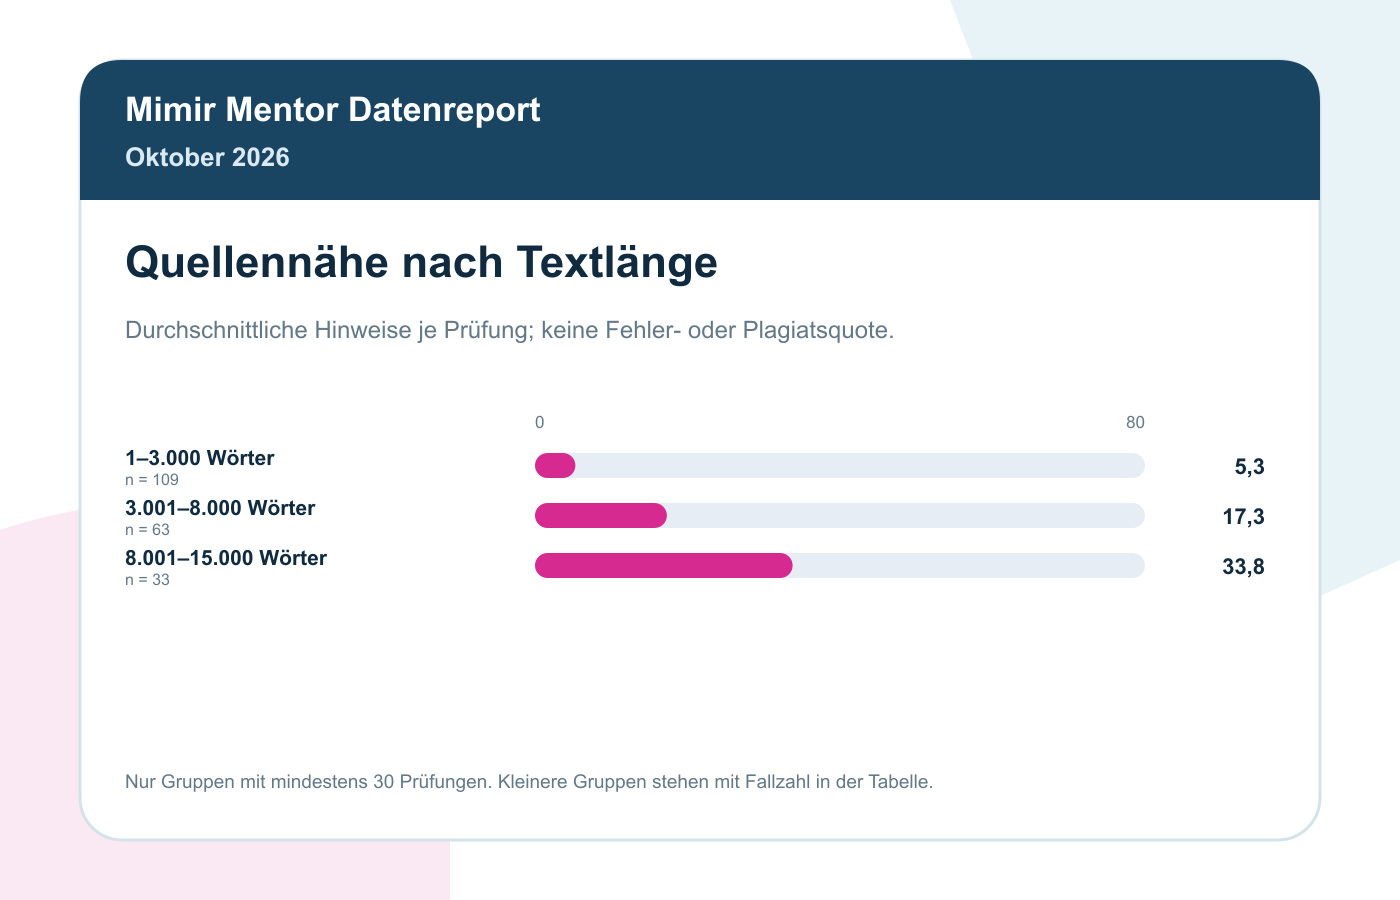
Längere Arbeiten bieten mehr Text, in dem Ähnlichkeiten erkannt werden können. Deshalb zeigen wir die Hinweismenge pro Prüfung und die Fallzahl jeder Gruppe. Ein höherer Wert bedeutet nicht, dass diese Gruppe häufiger plagiiert.
| Textlänge | Prüfungen n | Ø Hinweise je Prüfung |
|---|---|---|
| 1–3.000 Wörter | 109 | 5,3 |
| 3.001–8.000 Wörter | 63 | 17,3 |
| 8.001–15.000 Wörter | 33 | 33,8 |
| 15.001–30.000 Wörter | 29 | Nicht verglichen: n unter 30 |
| Über 30.000 Wörter | 15 | Nicht verglichen: n unter 30 |
| Nicht zugeordnet | 1 | Nicht verglichen: n unter 30 |
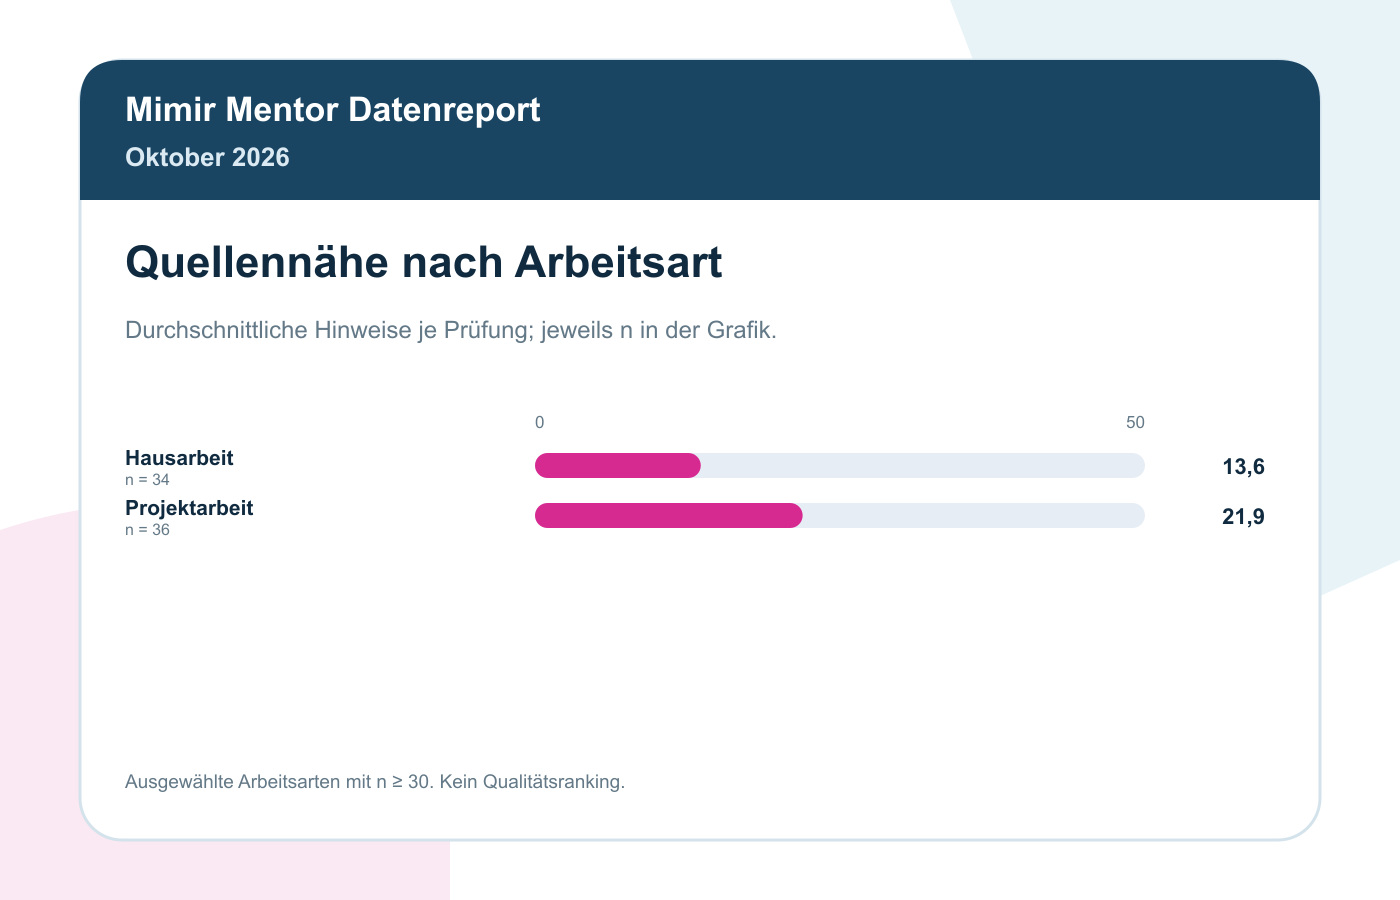
| Arbeitsart | Prüfungen n | Ø Hinweise je Prüfung |
|---|---|---|
| Bachelorarbeit | 28 | Nicht verglichen: n unter 30 |
| Dissertation | 5 | Nicht verglichen: n unter 30 |
| Essay | 8 | Nicht verglichen: n unter 30 |
| Facharbeit | 15 | Nicht verglichen: n unter 30 |
| Hausarbeit | 34 | 13,6 |
| Masterarbeit | 27 | Nicht verglichen: n unter 30 |
| Nicht zugeordnet | 1 | Nicht verglichen: n unter 30 |
| Praktikumsbericht | 18 | Nicht verglichen: n unter 30 |
| Projektarbeit | 36 | 21,9 |
| Seminararbeit | 11 | Nicht verglichen: n unter 30 |
| Sonstige | 67 | 14,9 |
Literaturarbeit oder empirische Arbeit: Macht das einen Unterschied?
Der Methodiktyp ist etwas anderes als der Abschluss: Eine Bachelorarbeit kann literaturbasiert, qualitativ, quantitativ oder kombiniert angelegt sein. Die Einordnung erfolgt automatisch und kann ungenau sein. Die folgenden Werte beschreiben diese Gruppen, ohne Unterschiede ursächlich einer Methode zuzuschreiben.
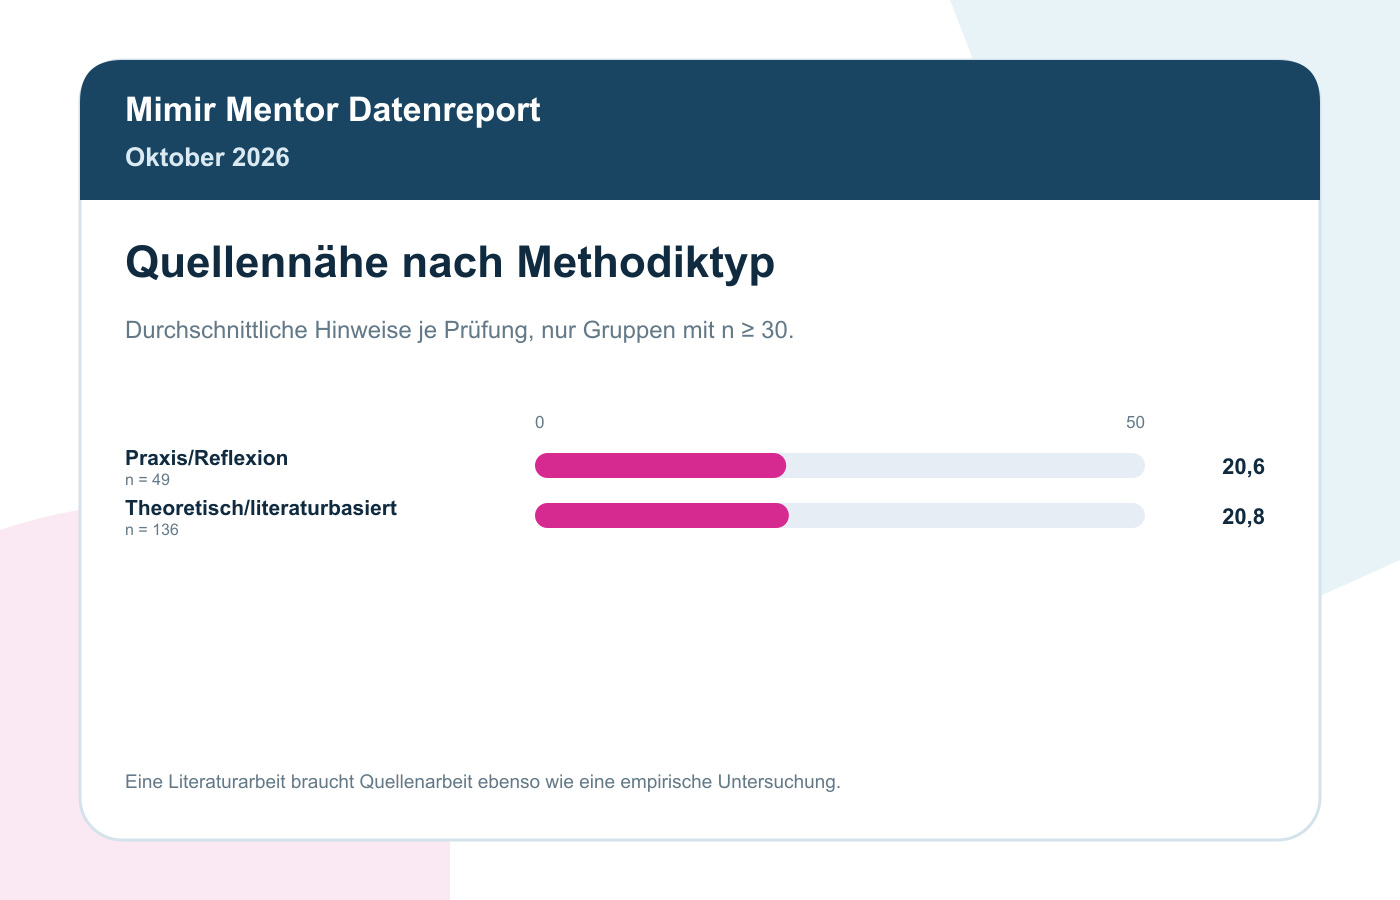
| Methodiktyp | Prüfungen n | Ø Hinweise je Prüfung |
|---|---|---|
| Empirisch qualitativ | 15 | Nicht verglichen: n unter 30 |
| Empirisch quantitativ | 27 | Nicht verglichen: n unter 30 |
| Mixed Methods | 7 | Nicht verglichen: n unter 30 |
| Nicht zugeordnet | 1 | Nicht verglichen: n unter 30 |
| Praxis/Reflexion | 49 | 20,6 |
| Sonstige | 15 | Nicht verglichen: n unter 30 |
| Theoretisch/literaturbasiert | 136 | 20,8 |
Studienbereiche: Fallzahlen vor Ranglisten
| Studienbereich | Prüfungen n | Ø Hinweise je Prüfung |
|---|---|---|
| Bildung/Pädagogik | 40 | 22,9 |
| Geisteswissenschaften | 19 | Nicht verglichen: n unter 30 |
| Informatik/IT | 4 | Nicht verglichen: n unter 30 |
| Ingenieurwissenschaften | 12 | Nicht verglichen: n unter 30 |
| Medien/Design | 7 | Nicht verglichen: n unter 30 |
| Medizin/Gesundheit | 47 | 26,6 |
| Naturwissenschaften | 10 | Nicht verglichen: n unter 30 |
| Nicht zugeordnet | 1 | Nicht verglichen: n unter 30 |
| Psychologie | 18 | Nicht verglichen: n unter 30 |
| Recht | 19 | Nicht verglichen: n unter 30 |
| Sonstige | 16 | Nicht verglichen: n unter 30 |
| Sozialwissenschaften | 23 | Nicht verglichen: n unter 30 |
| Wirtschaft/Management | 34 | 25,4 |
n bezeichnet ausgewählte Prüfläufe, nicht Personen. Bei n unter 30 werden keine Vergleichswerte dargestellt. Auch größere Gruppen sind nicht repräsentativ.
Was ergänzt die KI-Erkennung?
Für 246 der 250 ausgewählten Prüfungen liegt ein nutzbarer KI-Erkennungswert vor. Sein Median beträgt 3,4 Prozent. 80 Werte liegen bei mindestens 10 Prozent, 23 bei mindestens 50 Prozent. Die Schwellen überschneiden sich: Die zweite Gruppe ist in der ersten enthalten.
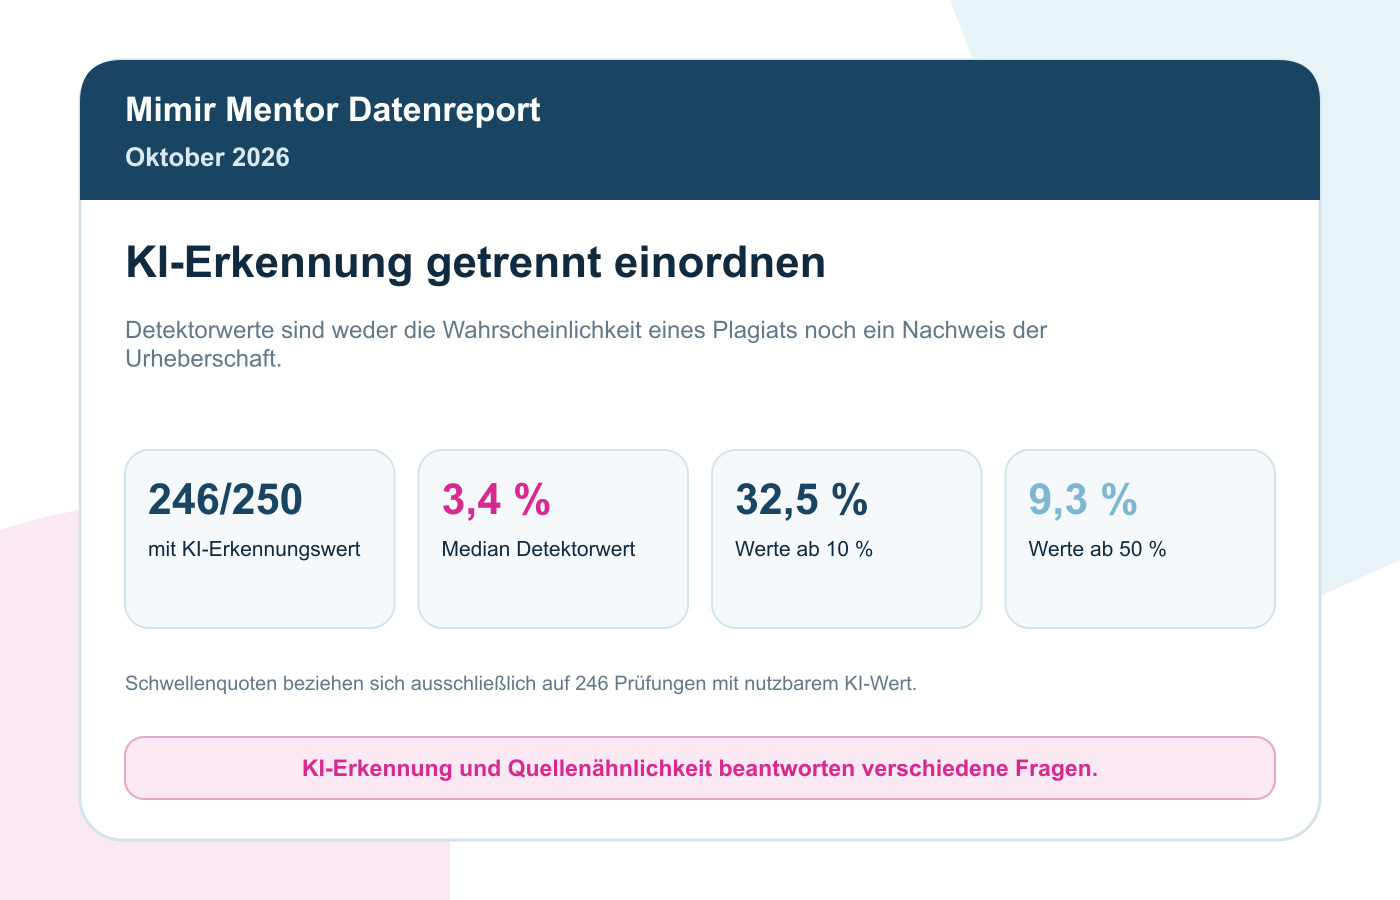
Aus diesen getrennten Kennzahlen folgt nicht, dass KI die Paraphrasen verursacht hat. Dafür müsste der Zusammenhang auf geeigneter Datenbasis gesondert untersucht werden; auch dann wäre eine Ursache noch nicht bewiesen.
In welcher Reihenfolge solltest du Hinweise bearbeiten?
- Markierte Stelle und Originalquelle nebeneinander lesen.
- Wörtliche Übernahmen und indirekte Zitate unterscheiden.
- Belege, Seitenangaben und Kennzeichnung prüfen.
- Zu enge Formulierungen aus dem eigenen Verständnis neu schreiben, nicht nur Wörter ersetzen.
- Anschließend sprachliche Änderungen auf unveränderte Bedeutung kontrollieren.
Der Korrekturreport Oktober 2026 erklärt, warum Umformulierungen keine eigene, trennscharfe Fehlerart sind. Der Literaturreport Oktober 2026 betrachtet Verzeichnisse und Zitierhinweise separat.
Überarbeite eine Formulierung, ohne die Quelle und ihre Aussage aus dem Blick zu verlieren
Methodik, Grenzen und Quellenangabe
Ausgewertet wurden abgeschlossene Produktionsprüfungen vom 1. bis 31. Oktober 2026. Die Monatsgrenzen sind in UTC definiert. Für diesen Report kommen abgeschlossene Dokumentprüfungen mit aktiviertem Quellenabgleich und vorhandenen Ergebniszählern infrage, egal ob kostenlos oder Premium. Seit dem 4. Oktober 2026 ist dieser Abgleich auch in der kostenlosen Dokumentprüfung aktiviert, davor nur in der Premium-Prüfung. Ob das Modul in jedem Einzelfall vollständig durchlief, lässt sich aus dem verwendeten Ereignis nicht absichern. 10 der 250 ausgewählten Prüfungen sind Premium-Läufe. Vor der Stichprobenauswahl wurde je Dokument-ID nur das zeitlich letzte geeignete Ergebnis im Monat berücksichtigt. Danach erfolgte eine deterministische Auswahl mit festem Seed. Prüfungen ohne Treffer wurden nicht allein wegen ihres Ergebnisses ausgeschlossen.
Die Auswahl verwendet Abschlussereignisse aus dem analytischen Dokumentprüfprozess mit den erforderlichen Ergebnisfeldern. Technische Abschlussmeldungen aus anderen Erfassungspfaden werden nicht damit vermischt. Eine Dokument-ID ist nicht gleichbedeutend mit einer Person oder einer einzigartigen wissenschaftlichen Arbeit: Wird derselbe Text unter einer neuen ID hochgeladen, kann er erneut vorkommen. Die Auswertung bereinigt Dokument-IDs, nicht semantisch identische Texte.
Auch Kapitel, kurze Textausschnitte und Zwischenstände können enthalten sein. Der feste Seed macht die Auswahl bei unverändertem Datenbestand wiederholbar. Später ergänzte oder korrigierte Ereignisse können einen erneuten Abruf verändern; für diesen Report gilt der gespeicherte aggregierte Datenstand vom 5. November 2026. Mediane folgen der in der Auswertung verwendeten diskreten Quantildefinition.
KI-Kennzahlen verwenden nur vorhandene Werte mit abgeschlossenem KI-Erkennungsstatus. Fehlende oder nicht abgeschlossene Werte werden nicht als null gewertet.
| Methodisches Merkmal | Festlegung |
|---|---|
| Zeitraum | 1.–31. Oktober 2026, UTC |
| Stichprobengröße | 250 ausgewählte Prüfungen |
| Auswahleinheit | Dokument-ID; letztes geeignetes abgeschlossenes Ergebnis im Monat |
| Auswahlverfahren | Deterministische Hash-Auswahl mit festem Seed; kein Positivfilter |
| Produktstand | In den ausgewerteten Ereignissen nicht verlässlich dokumentiert. Kein versionsbereinigter Monatsvergleich. |
| Datenstand | Auswertung vom 5. November 2026 |
| Datenquelle | Aggregierte Mimir-Mentor-Produktdaten |
DACH-Kontext, nicht DACH-Repräsentativität
53,8 Prozent der erfassten App-Aufrufe im Oktober 2026 waren Deutschland, Österreich oder der Schweiz zugeordnet. Das ist eine separate Nutzungsstatistik, keine Länderzuordnung der ausgewählten Dokumente. Sie belegt weder Nationalität noch Hochschulstandort; Geo-Zuordnungen können ungenau sein.
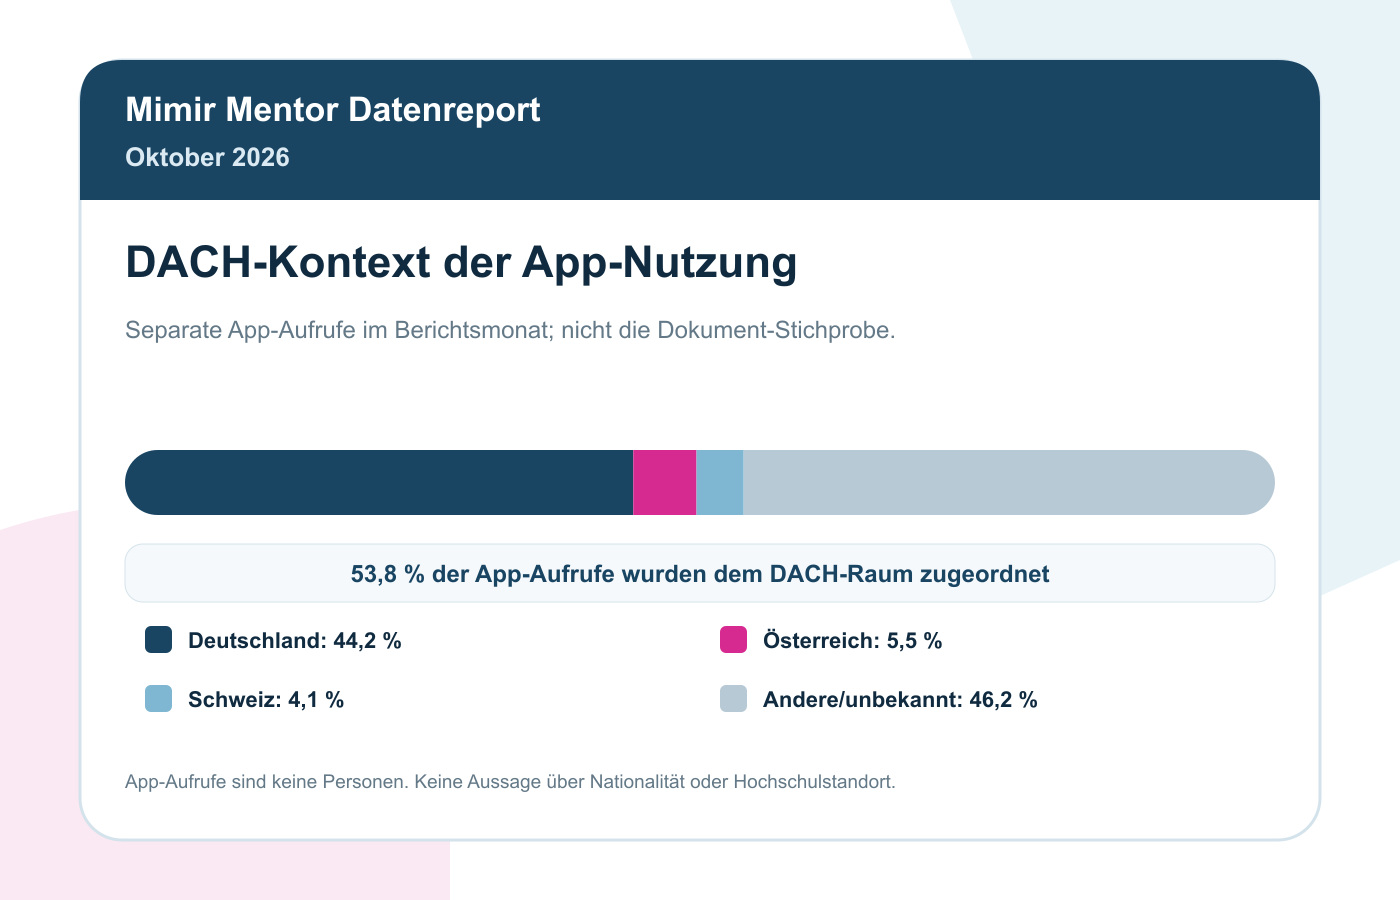
| App-Zuordnung | Anteil an erfassten App-Aufrufen |
|---|---|
| Deutschland | 44,2 % |
| Österreich | 5,5 % |
| Schweiz | 4,1 % |
| Andere oder unbekannt | 46,2 % |
Grenzen: Selbst ausgewählte Produktnutzung ist keine repräsentative Hochschulstichprobe. Hinweise hängen unter anderem von Textumfang, Erkennung und Prüfkonfiguration ab. Die Gruppenunterschiede sind keine Kausalaussagen. Monatswerte sollten nur bei bestätigter Vergleichbarkeit von Modulversion, Datenerfassung und Auswahl gegenübergestellt werden.
Zitierfähige Kernaussagen
- Im Mimir Plagiatsreport Oktober 2026 entfielen 86,8 % von 5.514 Hinweisen auf Quellennähe auf Paraphrasen (Basis: 250 Dokumentprüfungen).
- 228 von 250 ausgewählten Dokumentprüfungen enthielten mindestens einen Hinweis auf Quellennähe; ein Hinweis ist kein Plagiatsurteil.
- Der Median lag bei 9 Hinweisen auf Quellennähe je Prüfung.
Bitte übernimm bei Zitaten den genannten Nenner und verlinke diesen Report als Originalquelle.
Empfohlene Quellenangabe
Mimir Mentor (2026): Plagiatsprüfung-Statistik Oktober 2026: Was 250 Dokumentprüfungen zeigen. Aggregierte, dokumentbereinigte Stichprobe von 250 Prüfungen. Datenstand: 5. November 2026. Online verfügbar unter: https://mimir-mentor.com/blog/plagiatspruefung-statistik-oktober-2026/.
Für Rückfragen zu Zahlen und Methodik nutze den Chat auf der Website oder die Kontaktmöglichkeiten im Impressum.
Wissenschaftliche Formulierungen in Minuten Sekunden
FAQ: Häufige Fragen
Wie hoch ist die Plagiatsquote in der Stichprobe?
Eine Plagiatsquote wurde nicht ermittelt. Die Zahlen beschreiben markierte Quellenähnlichkeiten. Ob ein Plagiat vorliegt, muss im Kontext der Quelle und ihrer Kennzeichnung beurteilt werden.
Was bedeutet der Anteil der Paraphrase-Hinweise?
86,8 % bezieht sich auf 5.514 Hinweise, nicht auf den Anteil plagiierten Textes oder plagiierten Arbeiten.
Warum sind jetzt auch kostenlose Prüfungen enthalten?
Seit dem 4. Oktober 2026 ist der Quellen- und Ähnlichkeitsabgleich auch in der kostenlosen Dokumentprüfung aktiviert. Deshalb wertet dieser Report erstmals alle abgeschlossenen Prüfungen mit aktiviertem Abgleich und vorhandenen Ergebniszählern aus. Frühere Ausgaben enthalten nur Premium-Prüfungen und sind deshalb nicht direkt vergleichbar.
Beweisen KI-Werte, dass Paraphrasen durch KI entstanden sind?
Nein. Die getrennten Kennzahlen belegen weder eine Ursache noch die Urheberschaft eines Textes.
Ist ein höherer Wert in einem Fach ein höheres Plagiatsrisiko?
Nein. Umfang, Quellenarbeit und Gruppengröße unterscheiden sich. Die Auswertung liefert kein Fachranking.