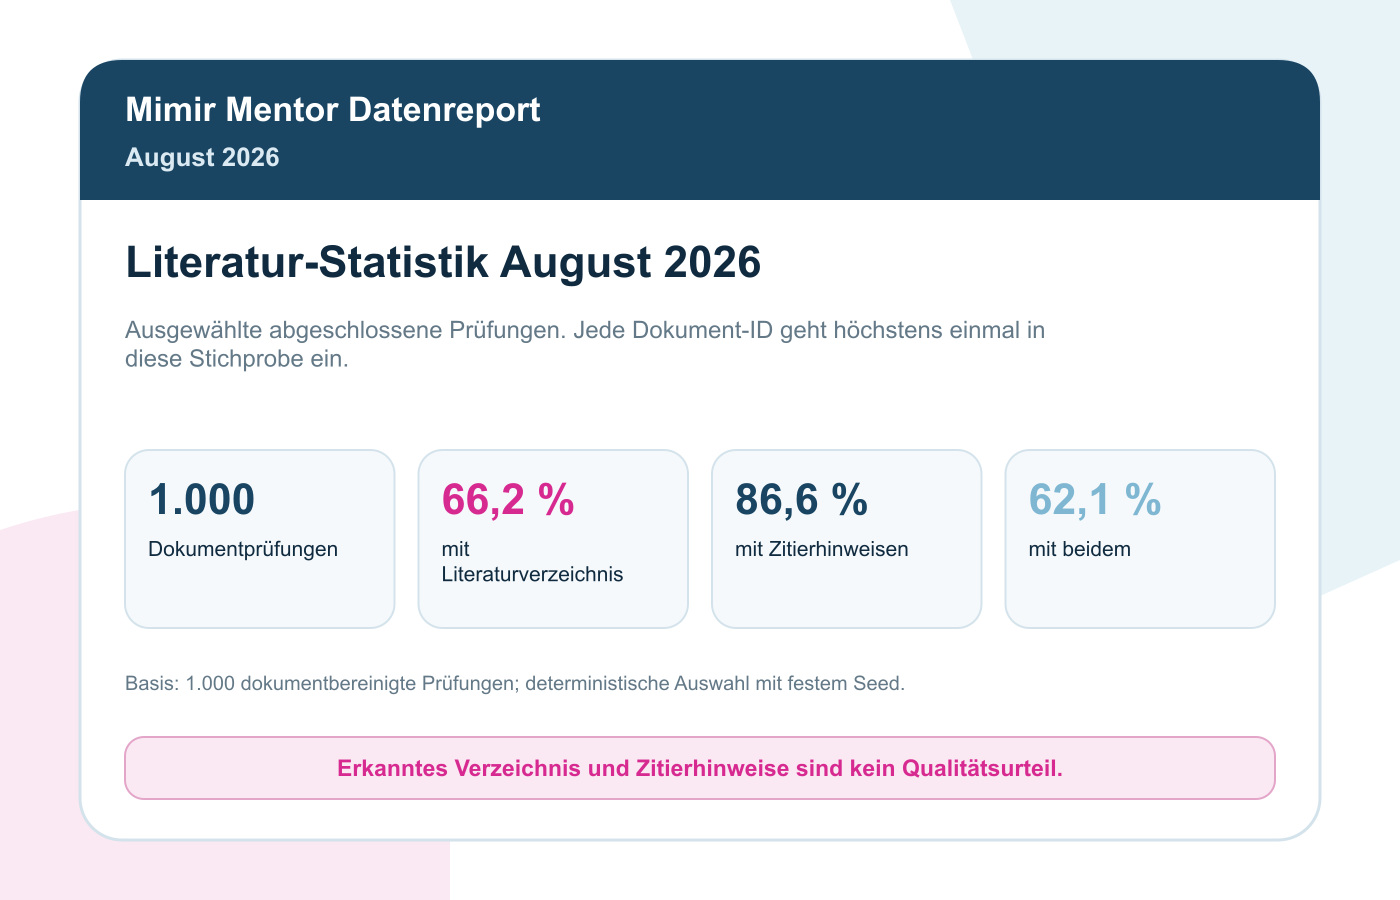
Wie viel Literaturarbeit steckt in einer wissenschaftlichen Arbeit? Für den Mimir Literaturreport August 2026 betrachten wir 1.000 ausgewählte Dokumentprüfungen: Wurde ein Verzeichnis erkannt, wie viele Einträge enthielt es und wie viele Zitierhinweise standen im Text?
Mimir Mentor ist eine KI-gestützte Plattform für wissenschaftliches Arbeiten mit Plagiatsprüfung, KI-Erkennung, Textkorrektur, Literaturrecherche und Zitierhilfe. Die passende Anwendung findest du unter Literaturrecherche. Dieser Report veröffentlicht ausschließlich aggregierte Kennzahlen, keine Dokumenttexte oder Quellenlisten.
Auf einen Blick: 66,2 % der Prüfungen hatten ein erkanntes Literaturverzeichnis, 86,6 % Zitierhinweise und 62,1 % beides. Das gleichzeitige Erkennen sagt noch nichts darüber, ob die Quellen zusammenpassen.
Die Übersicht aller Datenreports ordnet die Monatsauswertungen ein. Der Literaturreport Mai 2026 bleibt als eigenständige Quelle erhalten. Die Werte sind keine automatisch vergleichbare Zeitreihe.
Was wurde in den Dokumenten erkannt?
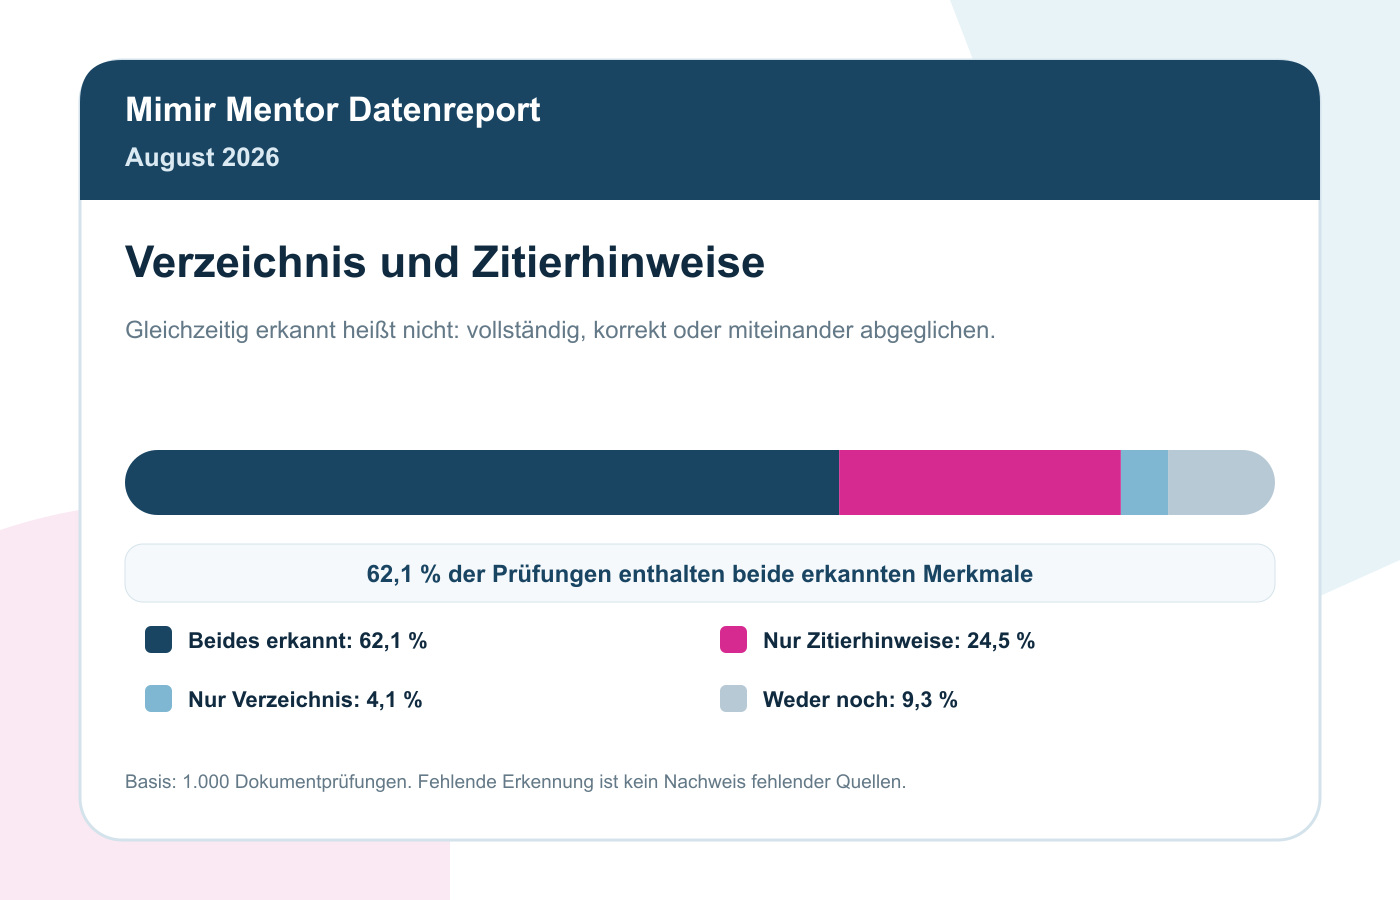
662 von 1.000 Prüfungen enthielten ein erkanntes Literaturverzeichnis. Bei 866 wurden Zitierhinweise im Text erfasst; bei 621 wurde beides erkannt. Die beiden Merkmale zählen unterschiedliche Dinge und dürfen sich überschneiden.
Ein Dokument ohne erkanntes Verzeichnis kann ein Kapitel, ein Zwischenstand oder ein Format ohne separates Verzeichnis sein. Auch Erkennungsgrenzen spielen eine Rolle. Daraus folgt nicht, dass die Arbeit keine Quellen verwendet oder schlecht gearbeitet wurde.
Wie oft wurden Verzeichnis und Zitierhinweise gemeinsam erkannt?
| Erkennungsstatus | Prüfungen | Anteil |
|---|---|---|
| Verzeichnis und Zitierhinweise | 621 | 62,1 % |
| Nur Zitierhinweise | 245 | 24,5 % |
| Nur Verzeichnis | 41 | 4,1 % |
| Weder noch erkannt | 93 | 9,3 % |
Zwei getrennte Prüfungen: „Beides vorhanden“ ist ein Strukturmerkmal. Ob jeder Kurzbeleg zum richtigen Eintrag führt und jeder Eintrag tatsächlich genutzt wird, muss gesondert abgeglichen werden.
Wie viele Einträge und Zitierhinweise wurden gezählt?
Bei den 662 Prüfungen mit erkanntem Verzeichnis liegt der Median bei 20 Einträgen, der Durchschnitt bei 30,8. Bei den 866 Prüfungen mit Zitierhinweisen beträgt der Median 37, der Durchschnitt 75,1 Hinweise.
| Kennzahl | Nenner | Median | Durchschnitt |
|---|---|---|---|
| Einträge im Literaturverzeichnis | 662 Prüfungen mit erkanntem Verzeichnis | 20 | 30,8 |
| Zitierhinweise im Text | 866 Prüfungen mit mindestens einem Zitierhinweis | 37 | 75,1 |
Zitierhinweise sind erfasste Textmarker, nicht automatisch unterschiedliche Quellen. Dieselbe Quelle kann mehrfach im Text auftauchen. Ebenso garantieren Verzeichnis-Einträge weder eindeutige Publikationen noch geprüfte bibliografische Richtigkeit. Eine „richtige Quellenanzahl“ lässt sich daraus nicht ableiten.
Suche gezielt nach Literatur für eine offene fachliche Frage
Wie verändert die Textlänge die Quellenarbeit?
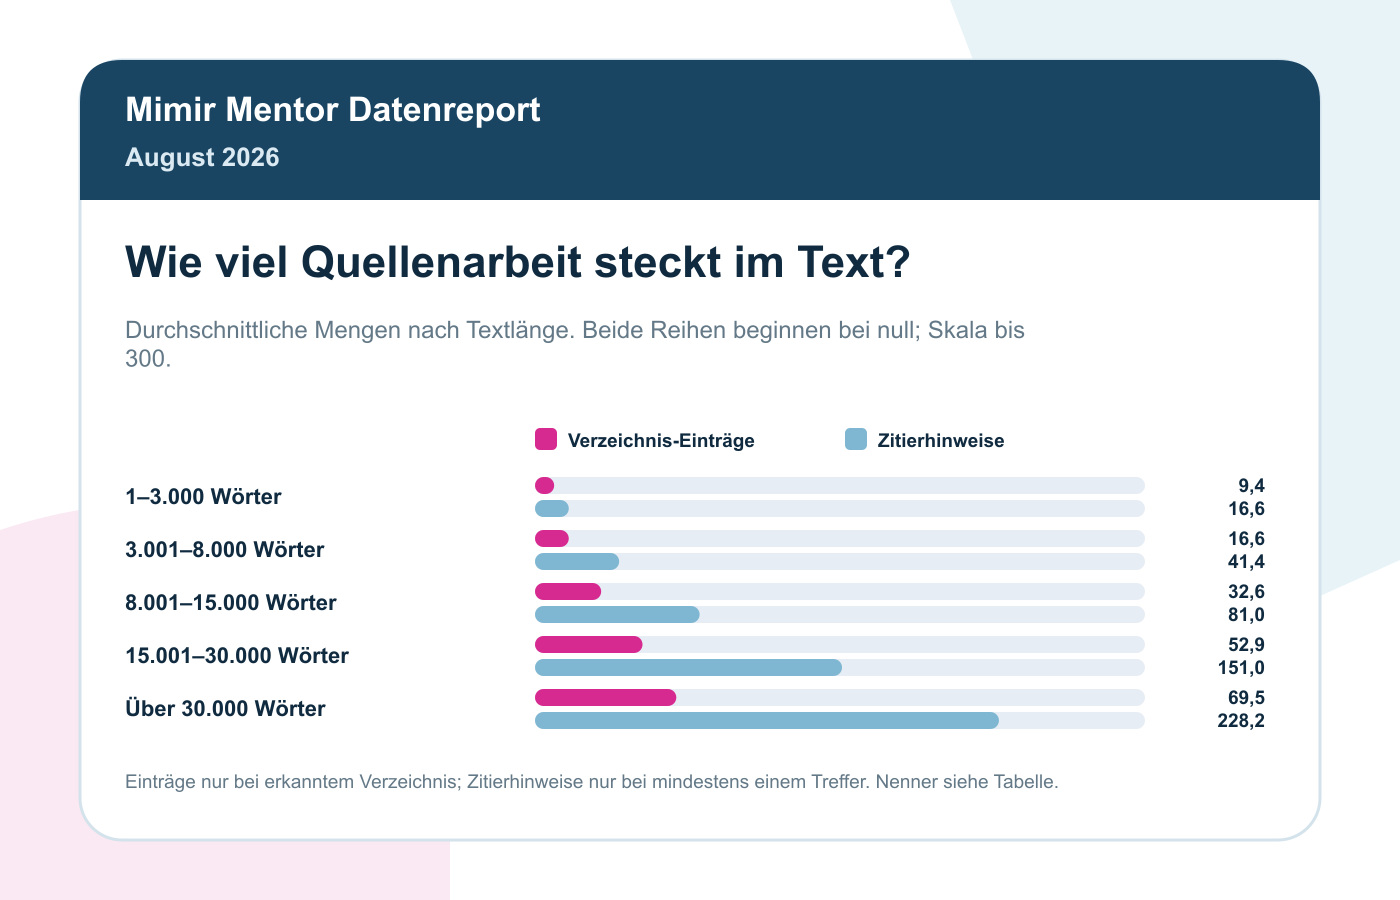
Mit mehr Text kann auch die Menge an Belegen und Verzeichnis-Einträgen wachsen. Die Tabelle vergleicht Mengen nur dort, wo das jeweilige Merkmal erkannt wurde. Für die beiden Spalten gelten deshalb unterschiedliche Nenner.
| Gruppe | n mit Verzeichnis | Ø Einträge | n mit Zitierhinweisen | Ø Zitierhinweise |
|---|---|---|---|---|
| Nicht zugeordnet | 0 | n unter 30 | 1 | n unter 30 |
| 1–3.000 Wörter | 81 | 9,4 | 172 | 16,6 |
| 3.001–8.000 Wörter | 247 | 16,6 | 308 | 41,4 |
| 8.001–15.000 Wörter | 143 | 32,6 | 177 | 81,0 |
| 15.001–30.000 Wörter | 145 | 52,9 | 160 | 151,0 |
| Über 30.000 Wörter | 46 | 69,5 | 48 | 228,2 |
Praktisch heißt das: Belege am besten beim Schreiben mitführen, statt das Verzeichnis erst kurz vor der Abgabe nachzubauen. Die Gruppenwerte sind eine Orientierung über den Arbeitsumfang, keine Mindestvorgabe deiner Hochschule.
Welche Rolle spielen Arbeitsart und Methodik?
Arbeitsart
Eine Masterarbeit und eine kurze Hausarbeit stellen häufig unterschiedliche Anforderungen an Umfang und Recherche. Für die Mengenwerte gelten auch hier getrennte Nenner; der Abschluss allein erklärt die Unterschiede nicht.
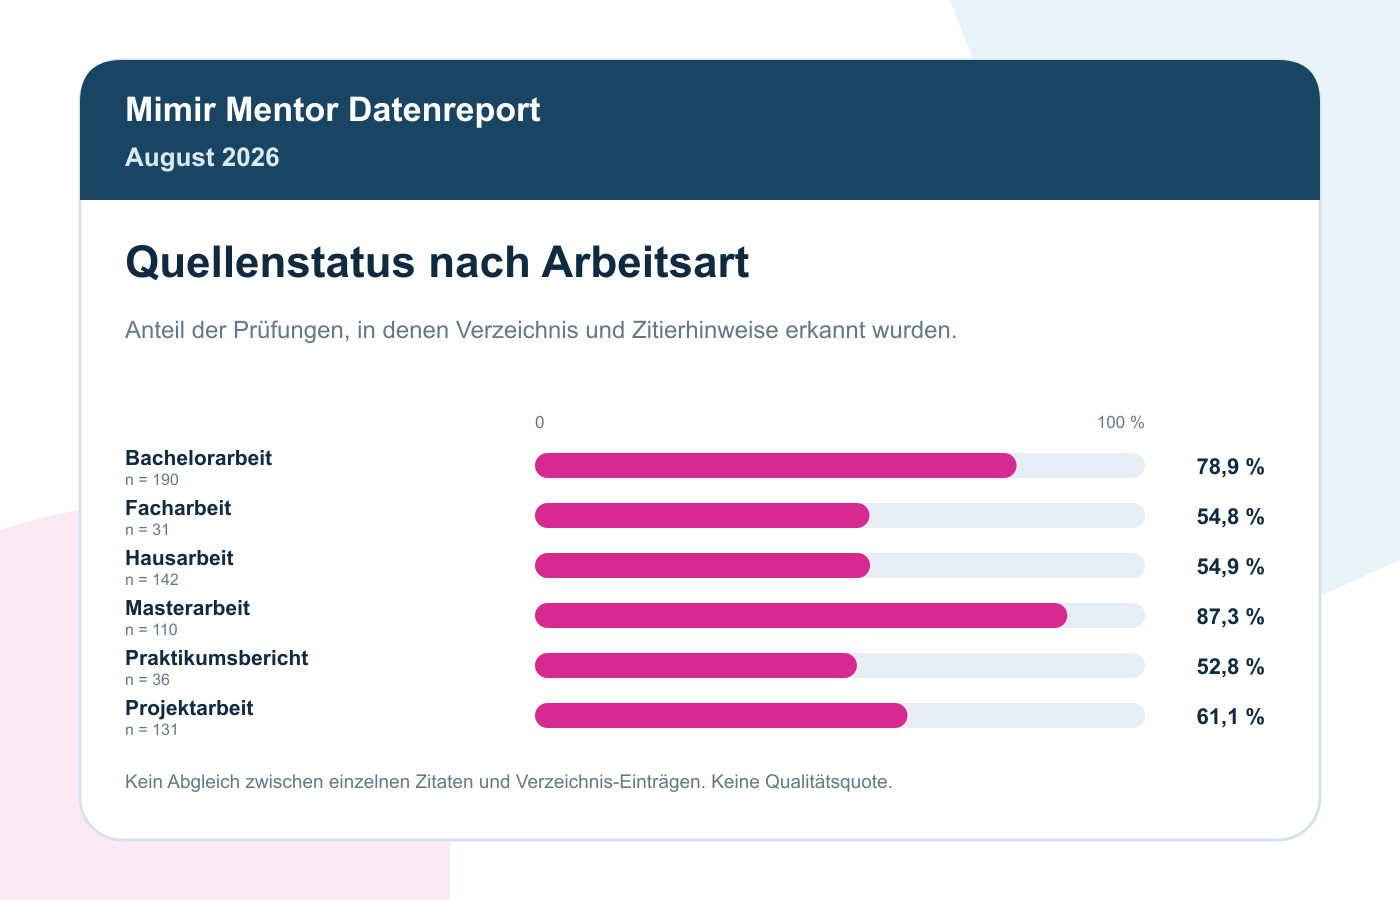
| Arbeitsart | Alle Prüfungen n | Beides erkannt | Anteil |
|---|---|---|---|
| Bachelorarbeit | 190 | 150 | 78,9 % |
| Dissertation | 10 | 8 | n unter 30 |
| Essay | 12 | 3 | n unter 30 |
| Facharbeit | 31 | 17 | 54,8 % |
| Hausarbeit | 142 | 78 | 54,9 % |
| Masterarbeit | 110 | 96 | 87,3 % |
| Nicht zugeordnet | 4 | 0 | n unter 30 |
| Praktikumsbericht | 36 | 19 | 52,8 % |
| Projektarbeit | 131 | 80 | 61,1 % |
| Seminararbeit | 163 | 109 | 66,9 % |
| Sonstige | 171 | 61 | 35,7 % |
| Gruppe | n mit Verzeichnis | Ø Einträge | n mit Zitierhinweisen | Ø Zitierhinweise |
|---|---|---|---|---|
| Bachelorarbeit | 155 | 37,4 | 177 | 104,2 |
| Dissertation | 8 | n unter 30 | 9 | n unter 30 |
| Essay | 5 | n unter 30 | 6 | n unter 30 |
| Facharbeit | 17 | n unter 30 | 29 | n unter 30 |
| Hausarbeit | 90 | 13,9 | 116 | 46,7 |
| Masterarbeit | 100 | 63,6 | 106 | 190,6 |
| Nicht zugeordnet | 0 | n unter 30 | 0 | n unter 30 |
| Praktikumsbericht | 21 | n unter 30 | 22 | n unter 30 |
| Projektarbeit | 85 | 15,9 | 113 | 36,9 |
| Seminararbeit | 120 | 20,0 | 147 | 38,7 |
| Sonstige | 61 | 29,4 | 141 | 64,6 |
Literaturbasiert, qualitativ, quantitativ oder kombiniert?
Der automatisch erkannte Methodiktyp ist vom Abschluss und Studienfach getrennt. Eine literaturbasierte Arbeit braucht ebenso eine nachvollziehbare Quellenführung wie eine empirische Untersuchung. Welche Quellen sinnvoll sind, bestimmt die Forschungsfrage.

| Methodiktyp | Prüfungen n | Beides erkannt | Anteil |
|---|---|---|---|
| Empirisch qualitativ | 108 | 78 | 72,2 % |
| Empirisch quantitativ | 156 | 123 | 78,8 % |
| Mixed Methods | 43 | 33 | 76,7 % |
| Nicht zugeordnet | 4 | 0 | n unter 30 |
| Praxis/Reflexion | 133 | 72 | 54,1 % |
| Sonstige | 22 | 2 | n unter 30 |
| Theoretisch/literaturbasiert | 534 | 313 | 58,6 % |
Studienbereiche als zusätzlicher Kontext
| Studienbereich | Prüfungen n | Beides erkannt | Anteil |
|---|---|---|---|
| Bildung/Pädagogik | 169 | 114 | 67,5 % |
| Geisteswissenschaften | 83 | 48 | 57,8 % |
| Informatik/IT | 58 | 38 | 65,5 % |
| Ingenieurwissenschaften | 65 | 42 | 64,6 % |
| Medien/Design | 17 | 9 | n unter 30 |
| Medizin/Gesundheit | 108 | 69 | 63,9 % |
| Naturwissenschaften | 34 | 23 | 67,6 % |
| Nicht zugeordnet | 4 | 0 | n unter 30 |
| Psychologie | 62 | 43 | 69,4 % |
| Recht | 73 | 26 | 35,6 % |
| Sonstige | 31 | 12 | 38,7 % |
| Sozialwissenschaften | 112 | 84 | 75,0 % |
| Wirtschaft/Management | 184 | 113 | 61,4 % |
n bezeichnet ausgewählte Prüfläufe, nicht Personen. Bei n unter 30 werden keine Vergleichswerte dargestellt. Auch größere Gruppen sind nicht repräsentativ.
Was solltest du vor der Abgabe kontrollieren?
- Jede fachlich übernommene Aussage auf einen nachvollziehbaren Beleg prüfen.
- Kurzbelege im Text mit den Einträgen im Verzeichnis abgleichen.
- Bei mehrfach genutzten Quellen konsistente Namen, Jahre und gegebenenfalls Seitenangaben kontrollieren.
- Nicht verwendete oder unvollständige Einträge prüfen, statt nur die Menge zu erhöhen.
- Erst danach Formulierungen glätten; Bedeutung und Quellenbezug müssen erhalten bleiben.
Die Literaturrecherche von Mimir Mentor unterstützt die Suche nach passenden Publikationen. Welche Quellenähnlichkeiten markiert werden, behandelt der Plagiatsreport August 2026. Sprachliche Vorschläge ordnet der Korrekturreport August 2026 ein.
Prüfe die sprachliche Einbettung deiner Quellen im Text
Methodik, Grenzen und Quellenangabe
Ausgewertet wurden abgeschlossene Produktionsprüfungen vom 1. bis 31. August 2026. Die Monatsgrenzen sind in UTC definiert. Vor der Stichprobenauswahl wurde je Dokument-ID nur das zeitlich letzte geeignete Ergebnis im Monat berücksichtigt. Danach erfolgte eine deterministische Auswahl mit festem Seed. Prüfungen ohne Treffer wurden nicht allein wegen ihres Ergebnisses ausgeschlossen.
Die Auswahl verwendet Abschlussereignisse aus dem analytischen Dokumentprüfprozess mit den erforderlichen Ergebnisfeldern. Technische Abschlussmeldungen aus anderen Erfassungspfaden werden nicht damit vermischt. Eine Dokument-ID ist nicht gleichbedeutend mit einer Person oder einer einzigartigen wissenschaftlichen Arbeit: Wird derselbe Text unter einer neuen ID hochgeladen, kann er erneut vorkommen. Die Auswertung bereinigt Dokument-IDs, nicht semantisch identische Texte.
Auch Kapitel, kurze Textausschnitte und Zwischenstände können enthalten sein. Der feste Seed macht die Auswahl bei unverändertem Datenbestand wiederholbar. Später ergänzte oder korrigierte Ereignisse können einen erneuten Abruf verändern; für diesen Report gilt der gespeicherte aggregierte Datenstand vom 5. September 2026. Mediane folgen der in der Auswertung verwendeten diskreten Quantildefinition.
| Methodisches Merkmal | Festlegung |
|---|---|
| Zeitraum | 1.–31. August 2026, UTC |
| Stichprobengröße | 1.000 ausgewählte Prüfungen |
| Auswahleinheit | Dokument-ID; letztes geeignetes abgeschlossenes Ergebnis im Monat |
| Auswahlverfahren | Deterministische Hash-Auswahl mit festem Seed; kein Positivfilter |
| Produktstand | In den ausgewerteten Ereignissen nicht verlässlich dokumentiert. Kein versionsbereinigter Monatsvergleich. |
| Datenstand | Auswertung vom 5. September 2026 |
| Datenquelle | Aggregierte Mimir-Mentor-Produktdaten |
Statusquoten verwenden alle 1.000 Prüfungen. Mengen im Literaturverzeichnis verwenden nur Prüfungen mit mindestens einem erkannten Eintrag; Zitiermengen nur Prüfungen mit mindestens einem Zitierhinweis. Die Erkennung ersetzt weder einen Vollständigkeits- noch einen Quellenabgleich.
DACH-Kontext, nicht DACH-Repräsentativität
96,0 Prozent der erfassten App-Aufrufe im August 2026 waren Deutschland, Österreich oder der Schweiz zugeordnet. Das ist eine separate Nutzungsstatistik, keine Länderzuordnung der ausgewählten Dokumente. Sie belegt weder Nationalität noch Hochschulstandort; Geo-Zuordnungen können ungenau sein.
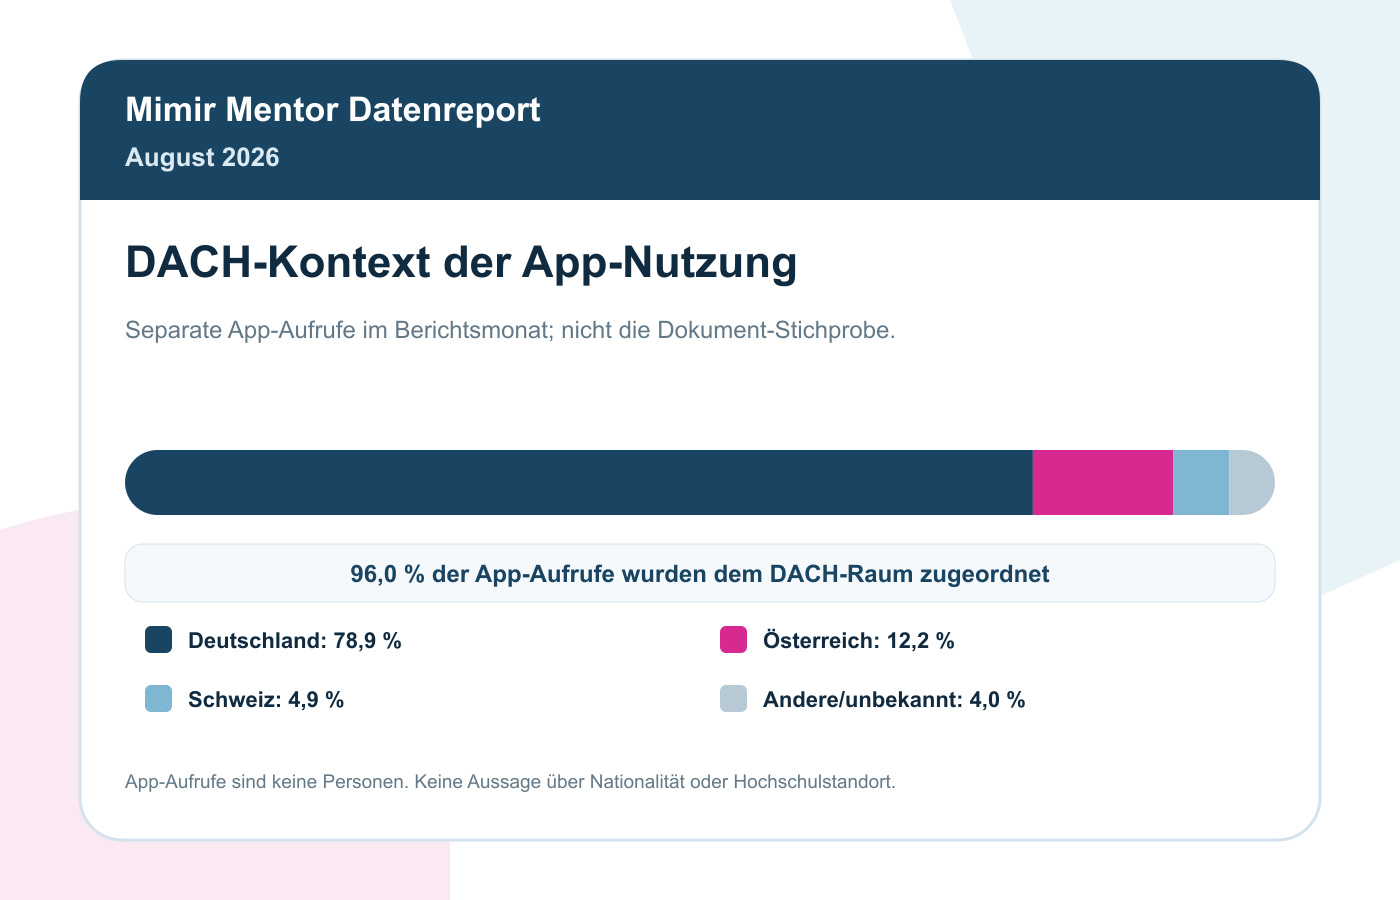
| App-Zuordnung | Anteil an erfassten App-Aufrufen |
|---|---|
| Deutschland | 78,9 % |
| Österreich | 12,2 % |
| Schweiz | 4,9 % |
| Andere oder unbekannt | 4,0 % |
Grenzen: Selbst ausgewählte Produktnutzung ist keine repräsentative Hochschulstichprobe. Hinweise hängen unter anderem von Textumfang, Erkennung und Prüfkonfiguration ab. Die Gruppenunterschiede sind keine Kausalaussagen. Monatswerte sollten nur bei bestätigter Vergleichbarkeit von Modulversion, Datenerfassung und Auswahl gegenübergestellt werden.
Empfohlene Quellenangabe
Mimir Mentor (2026): Literatur-Statistik August 2026: Quellen und Zitate in 1.000 Prüfungen. Aggregierte, dokumentbereinigte Stichprobe von 1.000 Prüfungen. Datenstand: 5. September 2026. Online verfügbar unter: https://mimir-mentor.com/blog/literatur-statistik-august-2026/.
Für Rückfragen zu Zahlen und Methodik nutze den Chat auf der Website oder die Kontaktmöglichkeiten im Impressum.
Wissenschaftliche Formulierungen in Minuten Sekunden
FAQ: Häufige Fragen
Wie viele Prüfungen hatten ein erkanntes Literaturverzeichnis?
662 von 1.000, also 66,2 %. Ein fehlendes Erkennungsergebnis ist kein Beweis, dass eine Arbeit ohne Quellen verfasst wurde.
Bedeutet beides erkannt, dass alle Zitate richtig zugeordnet sind?
Nein. Verzeichnis und Zitierhinweise werden hier als getrennte Strukturmerkmale gezählt. Ein Abgleich einzelner Quellen ist damit nicht belegt.
Sind Zitierhinweise verschiedene Quellen?
Nicht automatisch. Eine Quelle kann mehrfach im Text zitiert werden. Die Auswertung zählt erfasste Textmarker, nicht eindeutig verschiedene Publikationen.
Warum werden Mengen nur bei erkannten Verzeichnissen berechnet?
Fehlende Erkennung wird nicht als gemessene Menge null behandelt. Verzeichnis-Einträge und Zitiermengen haben deshalb jeweils einen eigenen bedingten Nenner.
Wie viele Quellen braucht meine Bachelorarbeit?
Aus einer Produktstichprobe lässt sich keine feste Vorgabe ableiten. Entscheidend sind Forschungsfrage, Fach, Arbeitsumfang und die Anforderungen der Hochschule.