


Come funziona davvero un AI detector? Se vuoi controllare il tuo testo prima della consegna, ti aiuta capire che cosa c’è dietro i rilevatori di IA. I metodi vanno dall’analisi statistica del linguaggio ai classificatori neurali fino alle filigrane digitali. Nessuno è perfetto, ma insieme danno un quadro significativo.
Questo articolo spiega i metodi di rilevamento più diffusi, ne mostra punti di forza e limiti e ti aiuta a capire che cosa dice davvero un report sull’IA. Mimir Mentor unisce AI detector e controllo antiplagio in un’unica analisi, così prima della consegna vai sul sicuro.
Quali metodi usano gli AI detector?
Gli AI detector riconoscono i testi generati dall’IA analizzando gli schemi linguistici tipici dei testi prodotti da una macchina. Gli approcci principali si dividono in quattro categorie: metriche statistiche, classificatori neurali, stilometria e filigrane. A seconda del sistema si usano procedimenti diversi. Le descrizioni pubbliche dei prodotti non rivelano sempre tutti i dettagli; da questa panoramica non si può quindi dedurre il funzionamento interno di ogni strumento.
| Metodo | Come funziona | Punto di forza | Punto debole |
|---|---|---|---|
| Analisi della perplessità | Misura quanto è prevedibile la scelta delle parole. I testi dell’IA hanno una perplessità bassa (lessico prevedibile). | Funziona bene con testi dell’IA non rielaborati | Fallisce con testi rielaborati, penalizza chi non scrive nella propria lingua madre |
| Analisi della burstiness | Misura la variazione di lunghezza e struttura delle frasi. I testi umani alternano frasi brevi e lunghe, quelli dell’IA sono più uniformi. | Completa la perplessità con uno sguardo alla struttura complessiva | I testi accademici hanno per natura una burstiness più bassa |
| Classificatori neurali | Modelli addestrati che imparano schemi da migliaia di esempi. Riconoscono caratteristiche sottili che le singole metriche non vedono. | Massima precisione con i modelli noti | Vanno riaddestrati per ogni nuovo modello di IA |
| Stilometria | Analizza lo stile di scrittura individuale: lessico, schemi sintattici, punteggiatura. Lo confronta con profili noti. | Riconosce cambi di stile all’interno di un testo | Servono testi di riferimento dell’autore |
| Filigrane | Firme statistiche invisibili inserite durante la generazione del testo. Per leggerle serve un rilevatore adatto al procedimento. | Il risultato dipende dal procedimento e dalle condizioni di test | Funzionano solo se il fornitore di IA collabora. Possono essere eliminate con la parafrasi. |
Che cosa sono perplessità e burstiness?
Perplessità (perplexity) e burstiness sono le metriche più note nel rilevamento dell’IA. GPTZero, uno dei primi AI detector, usava questi due valori come elemento centrale della sua analisi.
La perplessità misura quanto un modello linguistico è sorpreso da un testo. Se scrivi Sono andato dal fornaio e ho comprato del…, un modello linguistico si aspetta parole come pane o focaccia. Se invece c’è scritto caleidoscopio, la perplessità è alta. I testi generati dall’IA hanno di solito una perplessità bassa, perché scelgono proprio le parole più probabili.
La burstiness descrive quanto variano lunghezza e complessità delle frasi all’interno di un testo. Le persone alternano in modo naturale frasi brevi e incisive e costruzioni più lunghe e articolate. I testi dell’IA, invece, mantengono un livello più uniforme. Un testo in cui ogni frase ha da 15 a 20 parole appare sospetto ai rilevatori.
Nessuna delle due metriche, da sola, è una prova. La Goethe-Universität di Francoforte sottolinea che i risultati dei rilevatori di IA possono essere usati solo come supporto e da soli non valgono come prova dell’uso dell’IA (fonte: Goethe-Universität Frankfurt, in tedesco). Pangram Labs ha inoltre mostrato che i rilevatori basati su perplessità e burstiness classificano per errore come generati dall’IA, in modo sistematicamente più frequente, i testi di chi non scrive nella propria lingua madre (fonte: Pangram Labs).
Come lavorano i classificatori neurali?
I classificatori neurali vanno oltre le singole metriche. Vengono addestrati su grandi quantità di testi umani e generati dall’IA e imparano così a riconoscere schemi sottili, invisibili all’occhio umano.
Il vantaggio: possono considerare molte caratteristiche insieme e raggiungono quindi una precisione maggiore rispetto agli approcci puramente statistici. Mimir Mentor punta su una combinazione di analisi statistica e modelli addestrati, che valutano e segnalano il testo frase per frase.
La sfida: ogni volta che esce un nuovo modello di IA (per esempio GPT-5 o Claude 4), i classificatori vanno riaddestrati. Senza aggiornamenti regolari il tasso di rilevamento cala.
Controlla il tuo testo per individuare schemi dell’IA prima che lo faccia il tuo docente
Che cosa sono le filigrane digitali per i testi dell’IA?
Le filigrane digitali (watermark) sono firme invisibili che un modello di IA inserisce nella scelta delle parole mentre genera il testo. L’idea viene dalla ricerca di Kirchenbauer et al. (2023) (fonte: Kirchenbauer et al. (2023)). Durante la generazione di ogni parola, una parte del vocabolario viene inserita in una lista privilegiata. Il testo prodotto usa un numero di parole di questa lista significativamente più alto di quanto accadrebbe con un autore umano.
Una filigrana presuppone che sia stata inserita già durante la generazione del testo. Non ogni testo dell’IA contiene un segnale del genere. Per rilevarla servono il procedimento adatto ed eventualmente una chiave; tassi di errore e robustezza vanno verificati a parte.
Nella pratica il metodo delle filigrane ha dei limiti: gli studi di Sadasivan et al. (2023) mostrano che già una semplice parafrasi può eliminare efficacemente le filigrane (fonte: Sadasivan et al. (2023)). Quanto sia robusto un sistema concreto va testato in condizioni adeguate.
Quanto sono precisi davvero gli AI detector?
Nessun AI detector raggiunge una precisione del 100%. L’affidabilità dipende da diversi fattori: il modello di IA usato, la lunghezza del testo, il grado di rielaborazione e la lingua.
| Fattore | Effetto sul rilevamento | Che cosa dovresti sapere |
|---|---|---|
| Lunghezza del testo | I testi più lunghi (oltre 500 parole) vengono riconosciuti in modo più affidabile dei paragrafi brevi. | Per il controllo carica possibilmente l’intero testo, non solo singoli paragrafi. |
| Rielaborazione | Più un testo dell’IA è stato rielaborato, più è difficile riconoscerlo. | Formulazioni proprie ed esempi personali fanno la differenza maggiore. |
| Lingua | La maggior parte dei rilevatori è addestrata soprattutto sull’inglese. I testi in altre lingue, come l’italiano, vengono riconosciuti in modo meno affidabile. | Mimir è pensato per i testi accademici e analizza lavori in 12 lingue, tra cui l’italiano. |
| Modello di IA | I modelli più recenti (GPT-5, Claude 4) producono testi più simili a quelli umani rispetto ai precedenti. | I rilevatori vanno aggiornati regolarmente per riconoscere i nuovi modelli. |
| Tipo di testo | I testi accademici sono più difficili da classificare, perché il linguaggio accademico è per natura formale e uniforme. | Un valore di burstiness basso non è automaticamente sospetto in un testo accademico. |
In Germania il tribunale amministrativo di Kassel ha fissato nel febbraio 2026 regole generalizzabili sulla dimostrabilità dell’uso dell’IA negli esami. Anche se le sentenze non sono ancora definitive, mostrano una tendenza: università e tribunali sviluppano sempre più procedure per dimostrare l’uso dell’IA.
Che cosa significa il risultato di un controllo IA?
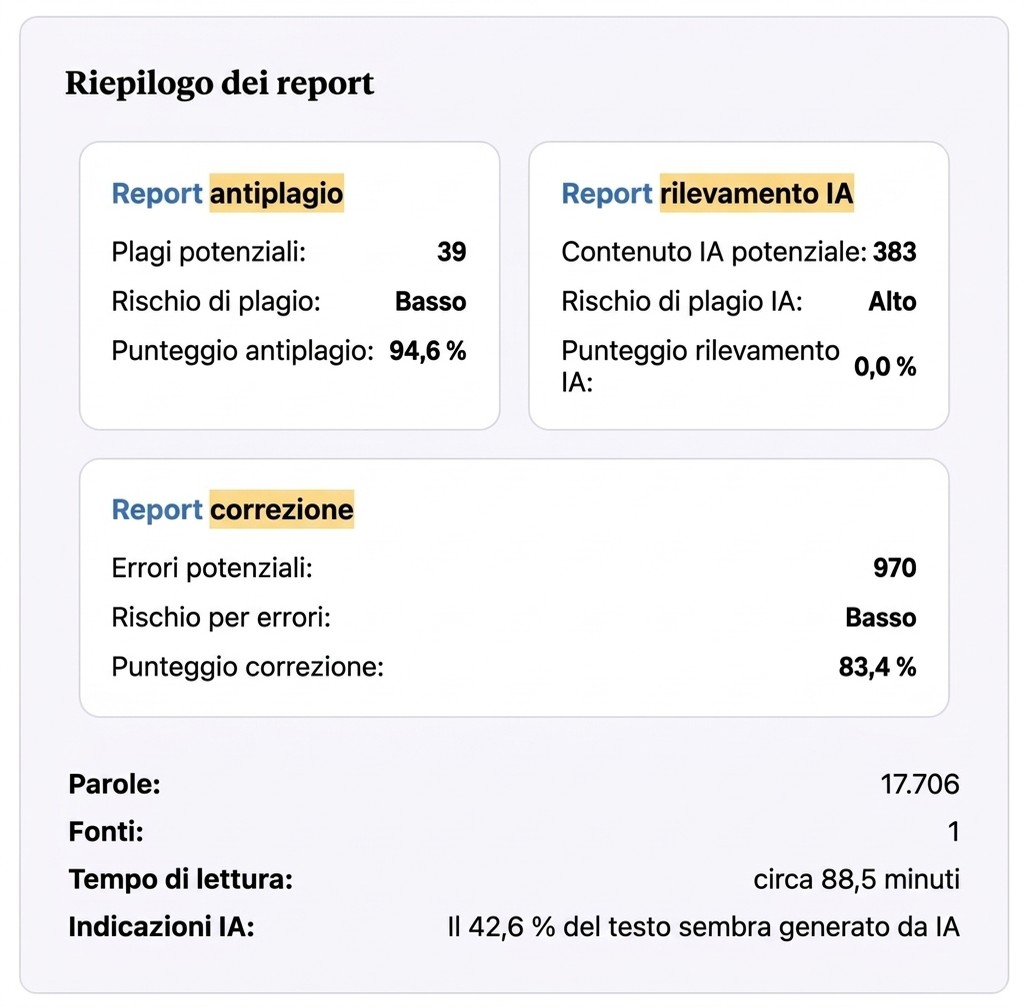
Un controllo IA fornisce di solito una percentuale, che indica quale parte del tuo testo è stata probabilmente generata da una macchina. Interpretare correttamente questo valore è decisivo.
Il valore è una probabilità, non una prova. Un risultato del 30% non significa che il 30% del tuo testo provenga da un’IA. Significa che il 30% del tuo testo presenta schemi linguistici tipici dei testi generati dall’IA. La differenza è importante, perché anche i testi umani possono mostrare questi schemi.
Che cosa fare: guarda uno per uno i passaggi segnalati. Riformula i passaggi che suonano vistosamente uniformi o prevedibili. Aggiungi esempi personali, termini della tua disciplina e analisi tue. Trovi altri dettagli nel nostro articolo sul rilevatore ChatGPT e su come controllare il tuo testo.
Fai analizzare ora il tuo testo per individuare schemi dell’IA e plagio
Come mettere al sicuro il tuo testo prima della consegna
Un controllo personale sistematico ti aiuta a trovare e correggere i punti problematici prima che il tuo docente controlli il testo.
- Scrivi tu: usa l’IA per il brainstorming e per la struttura, ma formula il testo con parole tue.
- Varia il tuo stile: alterna frasi brevi e lunghe. Usa termini tecnici, valutazioni personali ed esempi concreti.
- Controlla prima della consegna: carica il tuo testo su mimir-mentor.com. L’analisi controlla insieme parti scritte dall’IA, plagio e affermazioni senza fonte.
- Rivedi i punti segnalati: riformula i passaggi tipici dell’IA. Aggiungi le fonti mancanti con la ricerca bibliografica.
- Documenta l’uso dell’IA: se hai usato l’IA come strumento, annotalo nella dichiarazione sull’uso dell’IA. La nostra guida ti mostra come dichiararlo correttamente.
In che cosa il rilevamento dell’IA di Mimir si distingue da Turnitin e da altri strumenti lo scopri nel nostro articolo di confronto.
Se dopo la parte tecnica vuoi anche un inquadramento pratico, continua con Rilevatore ChatGPT, Testi dell’IA all’università: che cosa è permesso? e Dichiarare l’uso dell’IA.
Scrittura accademica in minuti secondi
FAQ: domande frequenti sulla tecnologia degli AI detector
-
Gli AI detector possono riconoscere ogni testo dell’IA?
No. Nessun rilevatore raggiunge una precisione del 100%. L’affidabilità dipende dal modello di IA, dalla lunghezza del testo e dal grado di rielaborazione. I testi dell’IA molto rielaborati, con esempi personali e un’argomentazione propria, sono molto più difficili da riconoscere.
-
Qual è la differenza tra perplessità e burstiness?
La perplessità misura quanto sono prevedibili le singole parole: una perplessità bassa indica un lessico prevedibile, tipico dell’IA. La burstiness misura la variazione di lunghezza e struttura delle frasi nell’intero testo. I testi umani hanno di solito una burstiness più alta dei testi generati dall’IA.
-
Gli AI detector possono controllare in modo affidabile i testi in italiano?
La maggior parte dei rilevatori internazionali è addestrata soprattutto su testi in inglese e riconosce in modo meno affidabile i testi dell’IA in altre lingue. Mimir Mentor è pensato per i testi accademici, analizza lavori in 12 lingue, tra cui l’italiano, e confronta le fonti con un database di oltre 200 milioni di pubblicazioni.
-
Il risultato di un AI detector basta come prova di frode?
No. La Goethe-Universität di Francoforte sottolinea nelle sue indicazioni che i software di rilevamento dell’IA possono essere usati solo come supporto e da soli non bastano come prova. Anche l’Università di Hohenheim ricorda che oggi una prova tecnica certa dell’uso dell’IA non è possibile. In Germania il tribunale amministrativo di Kassel ha inoltre fissato nel 2026 regole importanti sulla dimostrabilità.
-
Che cosa sono le filigrane digitali per i testi dell’IA?
Le filigrane sono firme statistiche invisibili che un modello di IA inserisce nella scelta delle parole durante la generazione del testo. Il metodo di base è stato descritto da Kirchenbauer et al. (2023). Allo stesso tempo Sadasivan et al. (2023) mostrano che queste filigrane si possono eliminare con la parafrasi.
-
Come evitare che un testo scritto da me venga segnalato per errore come IA?
Varia consapevolmente lunghezza e struttura delle frasi. Usa valutazioni personali, esempi della tua disciplina e analisi tue. Evita formulazioni generiche e frasi fatte. I testi accademici hanno per natura una burstiness più bassa, che può portare a falsi positivi.
-
In che cosa il rilevamento dell’IA di Mimir si distingue da GPTZero o Turnitin?
GPTZero si basa soprattutto su perplessità e burstiness. Turnitin usa propri classificatori neurali ed è di norma accessibile solo tramite le università. Se i testi consegnati vengano salvati dipende dalle impostazioni del singolo compito. Mimir combina più metodi, è pensato per i testi accademici in 12 lingue, è conforme al GDPR e cancella i documenti al più tardi dopo 30 giorni.

