


¿Cómo funciona un detector de IA en realidad? Si quieres revisar tu texto antes de entregarlo, conviene que entiendas qué hay detrás de estas herramientas. Los métodos van desde el análisis estadístico del lenguaje hasta los clasificadores neuronales y las marcas de agua digitales. Ninguno es perfecto, pero juntos ofrecen una imagen bastante reveladora.
Este artículo explica los métodos de detección más habituales, muestra sus puntos fuertes y sus límites y te ayuda a interpretar lo que dice de verdad un informe de IA. Mimir Mentor combina la detección de IA y la detección de plagio en un solo análisis, para que entregues tu trabajo con tranquilidad.
¿Qué métodos usan los detectores de IA?
Los detectores de IA reconocen los textos generados por inteligencia artificial analizando patrones lingüísticos típicos de la escritura automática. Los enfoques principales se agrupan en cuatro categorías: métricas estadísticas, clasificadores neuronales, estilometría y marcas de agua. Según el sistema, se combinan procedimientos distintos. Las descripciones públicas de los productos no siempre revelan todos los detalles, así que esta visión general no permite deducir cómo funciona internamente cada herramienta.
| Método | Cómo funciona | Punto fuerte | Punto débil |
|---|---|---|---|
| Análisis de perplejidad | Mide lo previsible que es la elección de palabras. Los textos de IA tienen una perplejidad baja (elección de palabras previsible). | Funciona bien con textos de IA sin editar | Falla con textos revisados y tiene sesgo contra hablantes no nativos |
| Análisis de variabilidad (burstiness) | Mide la variación en la longitud y la estructura de las frases. Los textos humanos alternan frases cortas y largas; los de IA son más uniformes. | Complementa la perplejidad con una mirada a la estructura global | Los textos académicos tienen por naturaleza una variabilidad más baja |
| Clasificadores neuronales | Modelos entrenados que aprenden patrones a partir de miles de ejemplos. Detectan rasgos sutiles que las métricas aisladas pasan por alto. | Máxima precisión con modelos conocidos | Hay que volver a entrenarlos con cada nuevo modelo de IA |
| Estilometría | Analiza el estilo individual de escritura: vocabulario, patrones sintácticos, puntuación. Lo compara con perfiles conocidos. | Detecta rupturas de estilo dentro de un mismo texto | Necesita textos de referencia del autor |
| Marcas de agua | Firmas estadísticas invisibles que se incrustan al generar el texto. Para leerlas hace falta un detector adaptado al procedimiento. | El resultado depende del procedimiento y de las condiciones de prueba | Solo funciona si el proveedor de IA participa. Puede eliminarse parafraseando. |
¿Qué son la perplejidad y la variabilidad (burstiness)?
La perplejidad y la variabilidad son las métricas más conocidas de la detección de IA. GPTZero, uno de los primeros detectores de IA, usó estos dos valores como núcleo de su análisis. En inglés se habla de perplexity y burstiness.
La perplejidad mide cuánto se sorprende un modelo de lenguaje ante un texto. Si escribes Fui a la panadería y compré…, el modelo espera palabras como pan o una barra. Si en su lugar aparece caleidoscopio, la perplejidad es alta. Los textos generados por IA suelen tener una perplejidad baja porque eligen precisamente las palabras más probables.
La variabilidad describe cuánto cambian la longitud y la complejidad de las frases dentro de un texto. Las personas alternan de forma natural frases breves y directas con construcciones más largas y subordinadas. Los textos de IA, en cambio, mantienen un nivel más uniforme. Un texto en el que todas las frases tienen entre 15 y 20 palabras resulta sospechoso para los detectores.
Ninguna de las dos métricas es una prueba por sí sola. La UNED advierte de que los detectores de IA pueden producir falsos positivos y falsos negativos y de que no deben emplearse como prueba concluyente ni como único criterio para valorar posibles casos de mala conducta académica (fuente: Investiga UNED). En Alemania, la Goethe-Universität de Fráncfort insiste en lo mismo: los resultados de detección de IA solo pueden usarse como apoyo y no bastan por sí solos como prueba del uso de IA (fuente: Goethe-Universität Frankfurt, en alemán). Además, Pangram Labs ha mostrado que los detectores basados en perplejidad y variabilidad se equivocan sistemáticamente más a menudo con los textos de hablantes no nativos y los clasifican como generados por IA (fuente: Pangram Labs).
¿Cómo funcionan los clasificadores neuronales?
Los clasificadores neuronales van más allá de las métricas aisladas. Se entrenan con grandes cantidades de textos humanos y generados por IA y aprenden a reconocer patrones sutiles que el ojo humano no ve.
La ventaja: pueden tener en cuenta muchos rasgos a la vez y, por eso, alcanzan una precisión mayor que los enfoques puramente estadísticos. Mimir Mentor combina el análisis estadístico con modelos entrenados que evalúan y marcan el texto frase por frase.
El reto: cada vez que aparece un nuevo modelo de IA (por ejemplo, una nueva versión de ChatGPT o de Claude), hay que volver a entrenar los clasificadores. Sin actualizaciones periódicas, la tasa de detección baja.
Revisa si tu texto tiene patrones de IA antes de que lo haga tu profesor
¿Qué son las marcas de agua digitales en los textos de IA?
Las marcas de agua digitales son firmas invisibles que un modelo de IA incrusta en la elección de palabras al generar un texto. La idea procede de la investigación de Kirchenbauer et al. (2023) (fuente: Kirchenbauer et al. (2023)). Al generar cada palabra, una parte del vocabulario pasa a una lista blanca (whitelist). El texto resultante usa, de forma estadísticamente significativa, más palabras de esa lista de las que usaría una persona.
Una marca de agua solo existe si se incrustó al generar el texto. No todos los textos de IA contienen esa señal. Para detectarla hace falta el procedimiento adecuado y, en su caso, una clave; las tasas de error y la robustez deben comprobarse por separado.
En la práctica, el método tiene límites: los estudios de Sadasivan et al. (2023) muestran que basta con parafrasear de forma sencilla para eliminar eficazmente las marcas de agua (fuente: Sadasivan et al. (2023)). La robustez de un sistema concreto debe comprobarse en condiciones adecuadas.
¿Qué precisión tienen realmente los detectores de IA?
Ningún detector de IA alcanza una precisión del 100 %. Su fiabilidad depende de varios factores: el modelo de IA utilizado, la longitud del texto, el grado de edición posterior y el idioma.
| Factor | Influencia en la detección | Lo que debes saber |
|---|---|---|
| Longitud del texto | Los textos largos (más de 500 palabras) se detectan con más fiabilidad que los párrafos sueltos. | Si puedes, sube el texto completo, no solo algunos párrafos. |
| Edición posterior | Cuanto más se ha revisado un texto de IA, más difícil es detectarlo. | Tus propias formulaciones y ejemplos personales marcan la mayor diferencia. |
| Idioma | La mayoría de los detectores se entrenan sobre todo con textos en inglés. En español y en otros idiomas, la detección puede ser menos fiable. | Comprueba qué idiomas admite la herramienta. Mimir Mentor analiza trabajos académicos en español, inglés, alemán y francés. |
| Modelo de IA | Los modelos más recientes generan textos más parecidos a los humanos que los antiguos. | Los detectores deben actualizarse con regularidad para reconocer los nuevos modelos. |
| Tipo de texto | Los textos científicos son más difíciles de clasificar porque el lenguaje académico es por naturaleza formal y uniforme. | Una variabilidad baja no es sospechosa por sí misma en un texto científico. |
En Alemania, el Tribunal Administrativo de Kassel fijó en febrero de 2026 criterios generalizables sobre cómo probar el uso de IA en exámenes. Aunque las sentencias aún no son firmes, muestran una tendencia: universidades y tribunales desarrollan cada vez más procedimientos para acreditar el uso de IA. En las universidades públicas españolas, la Ley 3/2022 de convivencia universitaria considera falta muy grave plagiar o cometer fraude académico en el TFG, el TFM o la tesis doctoral; las privadas aplican sus propias normas de convivencia.
¿Qué significa el resultado de un análisis de IA?
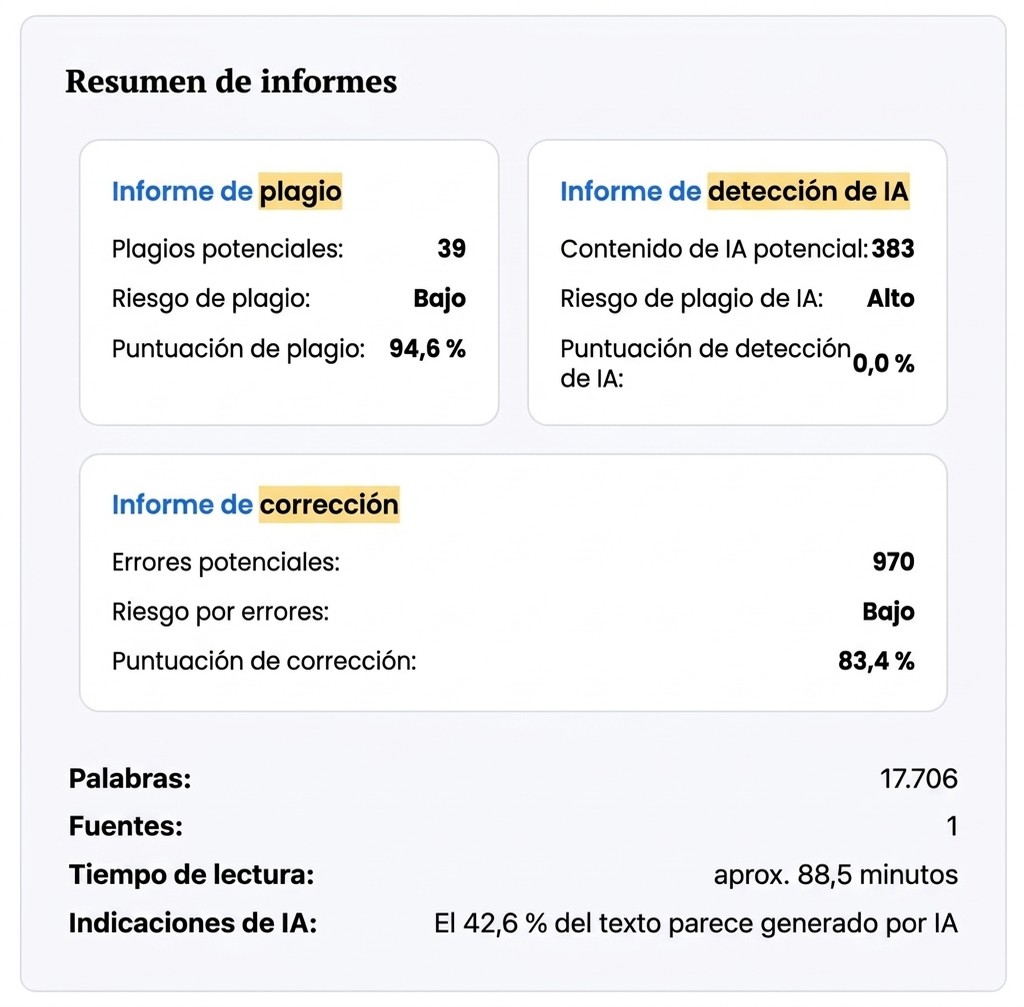
Un análisis de IA suele darte un porcentaje que indica qué parte de tu texto se generó probablemente de forma automática. Interpretar bien ese valor es decisivo.
El valor es una probabilidad, no una prueba. Un resultado del 30 % no significa que el 30 % de tu texto proceda de una IA. Significa que el 30 % de tu texto presenta patrones lingüísticos típicos de los textos generados por IA. La diferencia importa porque los textos humanos también pueden mostrar esos patrones.
Lo que deberías hacer: revisa uno a uno los pasajes marcados. Reformula los que suenen llamativamente uniformes o previsibles. Añade ejemplos personales, términos propios de tu disciplina y análisis propios. Encontrarás más información en nuestro artículo sobre la detección de IA y cómo revisar tu texto.
Analiza ahora tu texto en busca de patrones de IA y plagio
Cómo blindar tu texto antes de entregarlo
Una autorrevisión sistemática te ayuda a encontrar y corregir los pasajes problemáticos antes de que tu profesor revise el texto.
- Escribe tú: usa la IA para generar ideas y estructurar, pero redacta el texto con tus propias palabras.
- Varía tu estilo: alterna frases cortas y largas. Usa términos técnicos, valoraciones personales y ejemplos concretos.
- Revisa antes de entregar: sube tu texto a mimir-mentor.com. El análisis comprueba a la vez los fragmentos de IA, el plagio y las afirmaciones sin cita.
- Revisa los pasajes marcados: reformula los fragmentos típicos de IA. Añade las fuentes que falten con la búsqueda bibliográfica.
- Documenta tu uso de la IA: si has usado la IA como herramienta de apoyo, déjalo por escrito en una declaración de uso de IA. Nuestra guía te explica cómo hacerlo correctamente.
En nuestro artículo comparativo te contamos en qué se diferencia la detección de IA de Mimir de Turnitin y otras herramientas.
Si después de la parte técnica quieres el enfoque práctico, sigue leyendo en Detección de IA, IA en la universidad: ¿qué está permitido? y Cómo declarar el uso de IA.
Redacción académica en minutos segundos
Preguntas frecuentes sobre la tecnología de detección de IA
-
¿Pueden los detectores de IA reconocer cualquier texto generado por IA?
No. Ningún detector alcanza una precisión del 100 %. La fiabilidad depende del modelo de IA, de la longitud del texto y del grado de edición posterior. Los textos de IA muy revisados, con ejemplos personales y argumentación propia, son bastante más difíciles de detectar.
-
¿Qué diferencia hay entre la perplejidad y la variabilidad (burstiness)?
La perplejidad mide lo previsibles que son las palabras concretas: una perplejidad baja significa una elección de palabras previsible, típica de la IA. La variabilidad (en inglés, burstiness) mide cuánto varían la longitud y la estructura de las frases a lo largo de todo el texto. Los textos humanos suelen tener una variabilidad mayor que los generados por IA.
-
¿Pueden los detectores de IA analizar textos en español de forma fiable?
La mayoría de los detectores internacionales se entrenan sobre todo con textos en inglés, y en otros idiomas su fiabilidad puede ser menor. Por eso conviene comprobar qué idiomas admite cada herramienta. Mimir Mentor está pensado para trabajos académicos, analiza textos en español, inglés, alemán y francés y los compara con una base de datos de más de 200 millones de publicaciones.
-
¿Basta el resultado de un detector de IA como prueba de fraude?
No. La UNED advierte de que los detectores de IA no deben emplearse como prueba concluyente ni como único criterio para valorar posibles casos de mala conducta académica. En Alemania, la Goethe-Universität de Fráncfort subraya que el software de detección solo sirve de apoyo, y la Universidad de Hohenheim, que hoy no es posible demostrar técnicamente y sin lugar a dudas el uso de IA. Además, en 2026 el Tribunal Administrativo de Kassel fijó criterios importantes sobre cómo probarlo.
-
¿Qué son las marcas de agua digitales en los textos de IA?
Las marcas de agua son firmas estadísticas invisibles que un modelo de IA incrusta en la elección de palabras al generar un texto. El método en que se basan lo describieron Kirchenbauer et al. (2023). Al mismo tiempo, Sadasivan et al. (2023) muestran que estas marcas de agua pueden eliminarse parafraseando.
-
¿Cómo evito que un texto escrito por mí se marque por error como IA?
Varía a propósito la longitud y la estructura de tus frases. Usa valoraciones personales, ejemplos propios de tu disciplina y análisis propios. Evita las formulaciones genéricas y las frases hechas. Los textos académicos tienen por naturaleza una variabilidad más baja, lo que puede provocar falsos positivos.
-
¿En qué se diferencia la detección de IA de Mimir de GPTZero o Turnitin?
GPTZero se basa sobre todo en la perplejidad y la variabilidad. Turnitin usa sus propios clasificadores neuronales y, por lo general, solo es accesible a través de las universidades; que los textos entregados se guarden o no depende de la configuración de cada tarea. Mimir combina varios métodos, está pensado para textos académicos en español y otros idiomas, cumple el RGPD y elimina los documentos en un plazo máximo de 30 días.


