


Un détecteur de texte IA ne consulte pas un registre universel indiquant qui a rédigé chaque phrase. Selon sa méthode, il recherche des caractéristiques statistiques, applique un modèle de classification ou vérifie un marquage ajouté lors de la génération. Le résultat est un indice dépendant du système, de la langue et du texte analysé.
Mimir Mentor est une plateforme d’IA pour les travaux universitaires. Son détecteur de plagiat intègre un indicateur d’IA : il signale les passages présentant les caractéristiques typiques d’un texte généré par une IA, en plus de la comparaison avec les sources.
Quelles méthodes utilisent les détecteurs d’IA ?
Les détecteurs repèrent les textes générés en analysant des régularités typiques de la langue produite par une machine. On peut distinguer quatre grandes familles : l’analyse statistique, la classification par réseaux de neurones, la stylométrie et le filigrane.
| Méthode | Principe | Point fort | Point faible |
|---|---|---|---|
| Perplexité | Mesure à quel point le choix des mots est prévisible. Un texte généré a souvent une faible perplexité. | Efficace sur les textes générés non retouchés | Échoue sur les textes retravaillés, biais possible contre les personnes non natives |
| Variabilité | Mesure la variation de longueur et de construction des phrases. Un humain alterne davantage phrases courtes et longues. | Complète la perplexité par un regard sur l’ensemble | Les textes universitaires sont naturellement plus réguliers |
| Classifieurs neuronaux | Modèles entraînés sur de nombreux exemples, qui apprennent des caractéristiques qu’une seule mesure ne voit pas | Les plus précis sur les modèles connus | Doivent être réentraînés pour chaque nouveau modèle |
| Stylométrie | Analyse le style personnel : vocabulaire, construction, ponctuation. Compare avec des textes connus de l’auteur. | Repère les ruptures de style dans un texte | Nécessite des textes de référence de l’auteur |
| Filigrane | Signal statistique invisible introduit lors de la génération, lu par un détecteur adapté | Signal vérifiable lorsque le fournisseur et le protocole sont connus | Ne fonctionne que si le fournisseur de l’IA l’utilise, peut être effacé par une reformulation |
L’indicateur d’IA de Mimir Mentor combine analyse statistique et modèles entraînés. Comme tous les détecteurs, il doit suivre l’évolution des modèles de langage, car chaque nouvelle génération produit des textes un peu différents.
Les classifieurs : reconnaître des caractéristiques apprises
Un classifieur est entraîné sur des exemples de textes associés à des catégories. Il apprend des régularités et les utilise pour évaluer un nouveau passage. Ces régularités peuvent concerner le vocabulaire, les enchaînements ou d’autres représentations calculées par le modèle.
La difficulté apparaît lorsque le nouveau texte diffère des exemples d’entraînement : autre langue, domaine spécialisé, longueur réduite ou nouveau générateur. Un résultat obtenu sur des essais généraux en anglais ne décrit donc pas automatiquement la fiabilité sur un mémoire de droit en français.
Astuce : vérifie si ton texte présente des caractéristiques typiques de l’IA avant que ton enseignant ne le fasse.
Prévisibilité et variation : des indices, pas une signature
La perplexité mesure à quel point un modèle de langage est surpris par un texte. Si tu écris Je suis allé à la boulangerie et j’ai acheté une…, un modèle attend un mot comme baguette. Si la phrase se termine par un mot inattendu, la perplexité augmente. Un texte généré choisit souvent le mot le plus probable ; sa perplexité est donc plutôt faible.
La variabilité décrit à quel point la longueur et la complexité des phrases changent dans un texte. Un humain alterne naturellement des phrases courtes et des constructions plus longues. Un texte généré reste souvent plus régulier. GPTZero, l’un des premiers détecteurs, a fait connaître ces deux mesures.
En anglais, on parle de perplexity et de burstiness. Ils décrivent des mesures, pas une règle selon laquelle un texte régulier serait forcément artificiel.
Une définition technique, une consigne standardisée ou un texte écrit par une personne non native peuvent présenter des formes très régulières. À l’inverse, un texte généré peut être varié. Évite donc les diagnostics fondés uniquement sur quelques expressions jugées typiques de ChatGPT.
Le filigrane : un autre mécanisme
Un filigrane textuel repose sur un signal introduit par un système de génération compatible, puis recherché par un détecteur adapté. Il ne faut pas le confondre avec la classification d’un texte quelconque. Les travaux de Kirchenbauer et al. (2023) sur le filigrane illustrent cette famille de méthodes.
Un détecteur de filigrane ne peut pas supposer que tous les générateurs utilisent son protocole. L’absence de signal n’établit donc pas à elle seule qu’un texte a été rédigé sans IA. Le cadre technique du marquage doit être connu.
Quels facteurs influencent la fiabilité ?
Aucun détecteur n’atteint 100 % de précision. La fiabilité dépend de plusieurs facteurs.
| Facteur | Effet sur la détection | Ce qu’il faut savoir |
|---|---|---|
| Longueur du texte | Les textes longs sont évalués de façon plus fiable que les paragraphes isolés. | Fais vérifier si possible le texte complet, pas quelques paragraphes. |
| Retouches | Plus un texte généré a été retravaillé, plus il est difficile à repérer. | Un texte généré puis retouché reste un usage d’IA à déclarer si les consignes l’exigent. |
| Langue | La plupart des détecteurs sont d’abord entraînés sur l’anglais. | Vérifie que l’outil prend en charge le français et comment il a été validé. |
| Modèle d’IA | Les modèles récents produisent des textes plus proches d’une écriture humaine. | Les détecteurs doivent être mis à jour régulièrement. |
| Type de texte | Les textes scientifiques sont plus difficiles à classer, car la langue académique est formelle et régulière. | Une faible variabilité n’est pas suspecte en soi dans un mémoire. |
Comment interpréter un pourcentage ?
| Affichage possible | À vérifier dans la documentation |
|---|---|
| Score de classification | Échelle et seuils utilisés |
| Part de texte signalée | Passages inclus dans le calcul |
| Probabilité annoncée | Calibration et conditions de validation |
Ces trois grandeurs ne sont pas interchangeables. Un chiffre affiché à 80 % ne signifie pas nécessairement 80 % de probabilité que cet étudiant ait triché. L’outil peut décrire la part des passages analysés, et non une probabilité d’auteur.
Vérifie également ce qui a été exclu : listes, références, tableaux ou passages trop courts peuvent ne pas entrer dans la mesure.
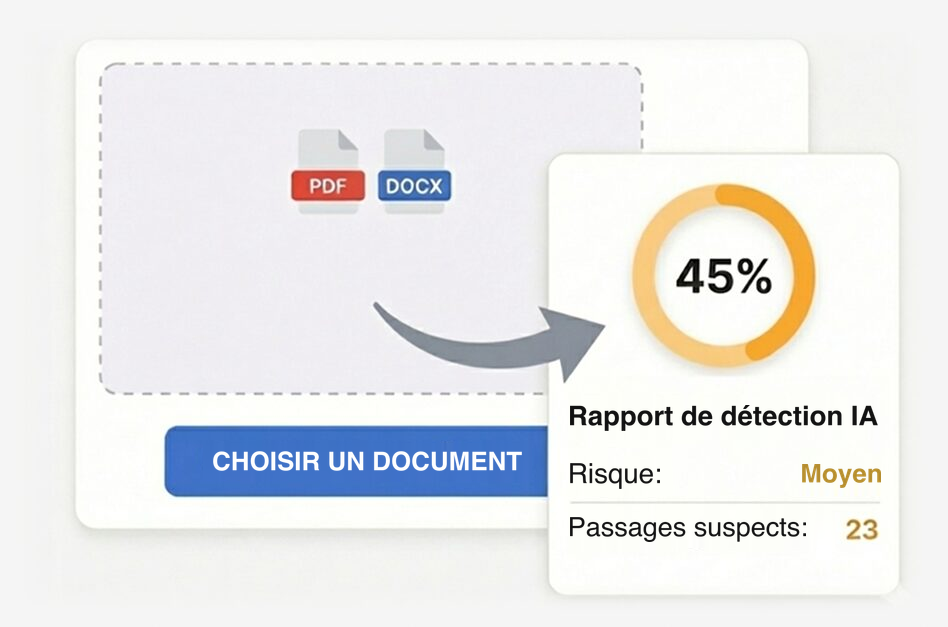
Un score de 30 % ne signifie pas que 30 % de ton texte vient d’une IA. Il indique, selon l’outil, qu’une partie du texte présente des caractéristiques typiques d’un texte généré. Regarde donc les passages signalés un par un. Si un passage signalé est bien de toi, garde tes brouillons pour l’expliquer. S’il vient d’une IA, réécris-le toi-même et déclare l’usage selon les consignes.
Astuce : fais analyser ton texte dès maintenant pour repérer les caractéristiques typiques de l’IA et les plagiats.
Faux positifs, faux négatifs et limites de validation
Un faux positif signale comme généré un texte humain. Un faux négatif ne repère pas un texte généré. Modifier un seuil peut réduire un type d’erreur tout en augmentant l’autre. Une annonce d’exactitude sans jeu de test ni taux d’erreurs séparés est donc difficile à interpréter.
L’étude Can AI-Generated Text be Reliably Detected? (Sadasivan et al., 2023) montre les limites de robustesse de la détection. Pour évaluer une offre, demande surtout des tests correspondant à ta langue, à ton genre de document et à des conditions comparables à ton usage.
Utiliser le résultat sans surinterpréter
- Identifie la méthode, la langue prise en charge et la version de l’outil.
- Lis les passages concernés plutôt que le score seul.
- Contrôle les affirmations et les sources indépendamment du diagnostic.
- Conserve tes notes, brouillons et versions de travail.
- Discute tout résultat contesté dans le cadre prévu par ton établissement.
Une recherche de plagiat répond à une autre question : l’existence de correspondances avec des sources. Notre guide sur la détection d’IA à l’université explique comment préparer une discussion sur un résultat.
Cinq réflexes avant la remise
- Écrire toi-même : utilise l’IA pour chercher des idées ou structurer, mais rédige le texte avec tes mots.
- Varier ton style : alterne phrases courtes et longues, utilise les termes de ta discipline, tes analyses et des exemples précis.
- Vérifier avant la remise : importe ton texte dans Mimir Mentor. L’analyse vérifie en même temps les passages typiques d’une IA, les correspondances avec des sources et les affirmations sans référence.
- Retravailler les passages signalés : vérifie qu’ils reflètent ton propre travail, réécris ce qui ne vient pas de toi et ajoute les sources manquantes grâce à la recherche bibliographique.
- Documenter l’usage de l’IA : si tu as utilisé une IA, déclare-le selon les consignes. Notre guide pour déclarer l’utilisation de l’IA te montre comment.
Pour les règles applicables, lis aussi notre article sur l’IA à l’université.
Contrôler ton texte avec Mimir Mentor avant la remise
Avec le détecteur de Mimir Mentor, tu vois avant la remise quels passages ressemblent à un texte d’IA et lesquels sont proches de sources existantes. L’analyse gratuite indique le nombre de passages signalés ; le détail phrase par phrase est inclus dans Premium. L’indicateur d’IA est un signal pour relire ces passages, pas une preuve : relis-les, vérifie tes sources et déclare l’usage réel de l’IA si ton établissement le demande.
Tes données restent protégées : Mimir Mentor est conforme au RGPD, avec des serveurs dans l’Union européenne. Les documents que tu soumets à une analyse sont traités pour cette analyse, supprimés au plus tard après 30 jours et ne sont ajoutés à aucune base de données publique. Ils ne servent pas aux vérifications d’autres utilisateurs et ne ressortiront donc pas comme correspondance lors d’un contrôle ultérieur. Plus de 70 000 étudiants utilisent déjà Mimir Mentor pour leurs travaux universitaires.
Vérifier mon texte gratuitement →
Rédaction académique en minutes secondes
Questions fréquentes
-
Un détecteur peut-il reconnaître tous les textes générés ?
Non. Ses performances dépendent notamment du générateur, de la langue, du type de texte et des conditions de validation.
-
La perplexité suffit-elle pour identifier une IA ?
Non. La prévisibilité statistique existe aussi dans des textes humains et dépend du modèle utilisé pour la mesurer.
-
Tous les textes IA contiennent-ils un filigrane ?
Non. Un filigrane suppose un système de génération et un protocole compatibles.
-
Un résultat identique avec deux outils constitue-t-il une preuve ?
Non. Les outils peuvent partager des limites ou exploiter des caractéristiques similaires. Le contexte et les éléments de rédaction restent nécessaires.
-
Pourquoi un court extrait est-il difficile à évaluer ?
Il fournit moins de contexte et moins de signal statistique. Vérifie les longueurs minimales et les réserves du service.
-
Comment éviter qu’un texte personnel soit signalé à tort ?
Écris avec ta propre voix, varie la longueur des phrases, ajoute tes analyses et des exemples précis, et garde tes brouillons et tes notes. En cas de signalement, ces traces aident à expliquer ta démarche.
-
Un résultat de détection suffit-il à prouver une fraude ?
Non. Un détecteur fournit des indices, pas une preuve. L’établissement doit examiner l’ensemble du dossier, et tu peux expliquer ta démarche avec tes notes et tes versions de travail.
-
Les détecteurs d’IA sont-ils fiables en français ?
Pas toujours. La plupart sont d’abord entraînés et validés sur l’anglais. Vérifie si l’outil prend en charge le français et sur quels textes il a été testé ; la documentation du rapport d’IA de Turnitin ne citait pas le français en septembre 2026.

