


Hur fungerar en AI-detektor egentligen? Om du vill kontrollera din text före inlämningen hjälper det att förstå vad som ligger bakom verktygen. Metoderna sträcker sig från statistisk språkanalys och neurala klassificerare till digitala vattenmärken. Ingen av dem är perfekt, men tillsammans ger de en användbar bild.
Den här artikeln förklarar de vanligaste metoderna för att upptäcka AI-text, visar deras styrkor och begränsningar och hjälper dig att förstå vad en AI-rapport faktiskt säger. Mimir Mentor kombinerar AI-detektor och plagiatkontroll i en och samma analys, så att du kan känna dig trygg före inlämningen.
Vilka metoder använder AI-detektorer?
AI-detektorer känner igen AI-genererade texter genom att analysera språkliga mönster som är typiska för maskinellt skapad text. De viktigaste angreppssätten kan delas in i fyra kategorier: statistiska mått, neurala klassificerare, stilometri och vattenmärken. Olika system använder olika metoder. Offentliga produktbeskrivningar redovisar inte alltid alla detaljer, så den här översikten säger inget om hur varje enskilt verktyg fungerar internt.
| Metod | Så fungerar den | Styrka | Svaghet |
|---|---|---|---|
| Perplexitetsanalys | Mäter hur förutsägbart ordvalet är. AI-texter har låg perplexitet (förutsägbart ordval). | Fungerar bra på AI-texter som inte har bearbetats | Misslyckas med bearbetade texter, snedvridning mot personer som inte skriver på sitt modersmål |
| Burstiness-analys | Mäter variationen i meningslängd och meningsbyggnad. Mänskliga texter växlar mellan korta och långa meningar, AI-texter är jämnare. | Kompletterar perplexiteten med en blick på helhetsstrukturen | Akademiska texter har naturligt lägre burstiness |
| Neurala klassificerare | Tränade modeller som lär sig mönster från tusentals exempel. De känner igen subtila drag som enskilda mått missar. | Högst träffsäkerhet för kända modeller | Måste tränas om för varje ny AI-modell |
| Stilometri | Analyserar den individuella skrivstilen: ordförråd, meningsmönster, interpunktion. Jämför med kända profiler. | Upptäcker stilbrott inom en text | Kräver referenstexter från författaren |
| Vattenmärken | Osynliga statistiska signaturer som bäddas in när texten skapas. För att läsa av dem krävs en detektor som passar till metoden. | Resultatet beror på metod och testförhållanden | Fungerar bara om AI-leverantören medverkar. Kan tas bort genom parafrasering. |
Vad är perplexitet och burstiness?
Perplexitet (engelska perplexity) och burstiness är de mest kända måtten för att upptäcka AI-text. GPTZero, en av de första AI-detektorerna, använde dessa två värden som kärnan i sin analys.
Perplexitet mäter hur överraskad en språkmodell blir av en text. Om du skriver Jag gick till bageriet och köpte en … förväntar sig en språkmodell ord som limpa eller kanelbulle. Står det i stället kalejdoskop blir perplexiteten hög. AI-genererade texter har typiskt låg perplexitet, eftersom de väljer just de mest sannolika orden.
Burstiness beskriver hur mycket meningslängd och komplexitet varierar inom en text. Människor växlar naturligt mellan korta, slagkraftiga meningar och längre, inskjutna konstruktioner. AI-texter håller däremot en jämnare nivå. En text där varje mening har 15 till 20 ord verkar misstänkt för detektorer.
Inget av måtten är ensamt ett bevis. Goethe-Universität i Frankfurt betonar att resultat från AI-detektering bara får användas som stöd och inte ensamma räcker som bevis för AI-användning (källa: Goethe-Universität Frankfurt, på tyska). Pangram Labs har dessutom visat att detektorer som bygger på perplexitet och burstiness systematiskt oftare felaktigt klassar texter av personer som inte skriver på sitt modersmål som AI-genererade (källa: Pangram Labs).
Hur fungerar neurala klassificerare?
Neurala klassificerare går längre än enskilda mått. De tränas på stora mängder mänskliga och AI-genererade texter och lär sig då känna igen subtila mönster som är osynliga för det mänskliga ögat.
Fördelen: de kan ta hänsyn till många drag samtidigt och når därmed högre träffsäkerhet än rent statistiska metoder. Mimir Mentor använder en kombination av statistisk analys och tränade modeller som bedömer och markerar texten mening för mening.
Utmaningen: varje gång en ny AI-modell kommer (till exempel en ny version av GPT eller Claude) måste klassificerarna tränas om. Utan regelbundna uppdateringar sjunker upptäcktsgraden.
Leta efter AI-mönster i din text innan din lärare gör det
Vad är digitala vattenmärken för AI-texter?
Digitala vattenmärken är osynliga signaturer som en AI-modell bäddar in i ordvalet när texten skapas. Idén kommer från forskning av Kirchenbauer m.fl. (2023) (källa: Kirchenbauer et al. (2023)). När varje ord genereras placeras en del av ordförrådet på en vitlista. Den skapade texten använder statistiskt signifikant fler ord från den listan än vad som hade varit fallet om en människa skrivit texten.
Ett vattenmärke förutsätter att det redan bäddades in när texten skapades. Inte varje AI-text innehåller en sådan signal. För att påvisa det krävs rätt metod och i vissa fall en nyckel; felfrekvens och robusthet måste prövas separat.
I praktiken har vattenmärkning sina begränsningar: studier av Sadasivan m.fl. (2023) visar att redan enkel parafrasering effektivt kan ta bort vattenmärken (källa: Sadasivan et al. (2023)). Hur robust ett konkret system är måste testas under lämpliga förhållanden.
Hur träffsäkra är AI-detektorer egentligen?
Ingen AI-detektor når 100 % träffsäkerhet. Tillförlitligheten beror på flera faktorer: vilken AI-modell som har använts, textens längd, hur mycket texten har bearbetats och språket.
| Faktor | Påverkan på upptäckten | Det här bör du veta |
|---|---|---|
| Textlängd | Längre texter (500+ ord) känns igen mer tillförlitligt än korta stycken. | Ladda helst upp hela texten för kontrollen, inte bara enskilda stycken. |
| Bearbetning | Ju mer en AI-text har bearbetats, desto svårare är den att känna igen. | Egna formuleringar och personliga exempel gör störst skillnad. |
| Språk | De flesta detektorer är främst tränade på engelska. Texter på andra språk, till exempel svenska, känns ofta igen mindre tillförlitligt. | Mimirs AI-detektor är utvecklad för akademiska texter och stöder svenska. |
| AI-modell | Nyare modeller skapar mer människolika texter än äldre. | Detektorer måste uppdateras regelbundet för att känna igen nya modeller. |
| Texttyp | Vetenskapliga texter är svårare att klassificera, eftersom akademiskt språk av naturen är formellt och jämnt. | Ett lågt burstiness-värde är inte automatiskt misstänkt i vetenskapliga texter. |
I Tyskland ställde förvaltningsdomstolen i Kassel (Verwaltungsgericht Kassel) i februari 2026 upp generella regler för hur AI-användning vid examination kan bevisas. Även om domarna ännu inte har vunnit laga kraft visar de att lärosäten och domstolar alltmer utvecklar förfaranden för att påvisa AI-användning. I Sverige prövas misstänkt vilseledande vid statliga lärosäten enligt högskoleförordningen 10 kap.
Vad betyder resultatet av en AI-kontroll?
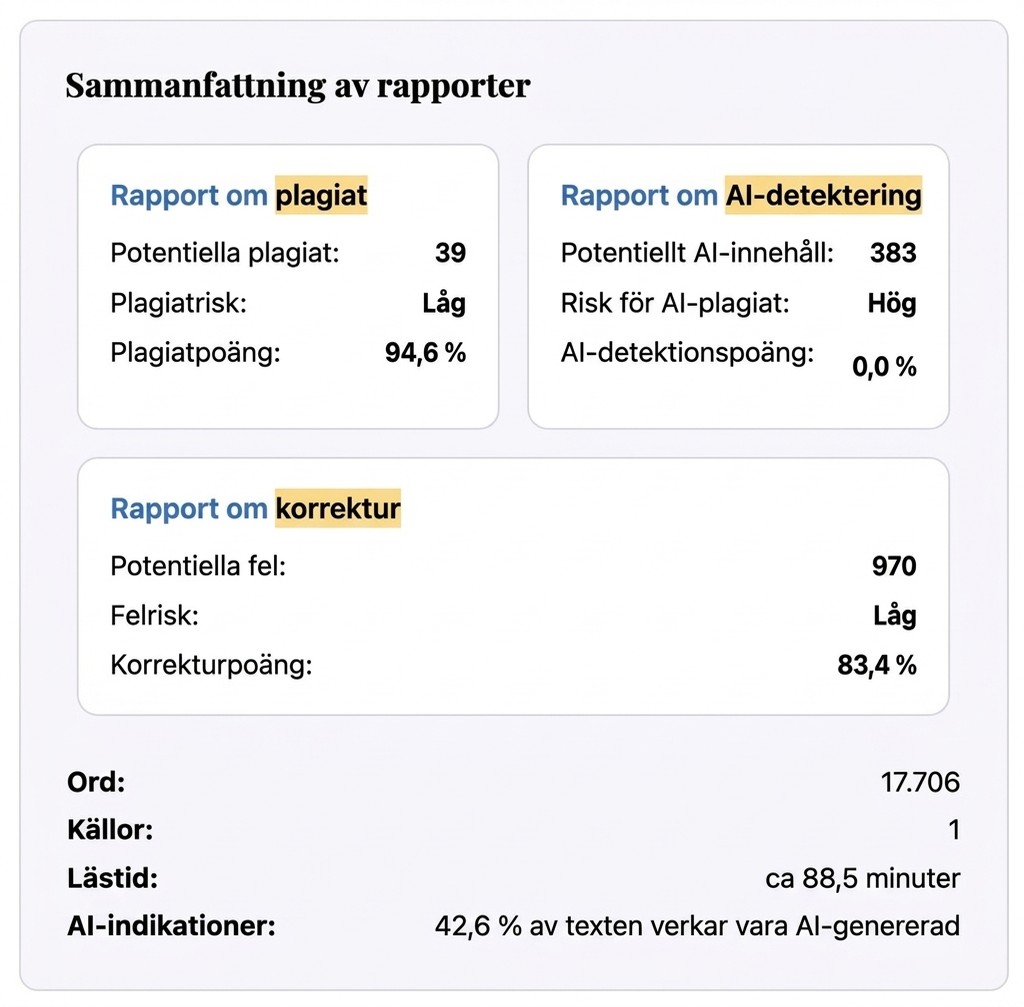
En AI-kontroll ger oftast ett procentvärde som anger hur stor del av din text som sannolikt har genererats maskinellt. Att tolka värdet rätt är avgörande.
Värdet är en sannolikhet, inget bevis. Ett resultat på 30 % betyder inte att 30 % av din text kommer från en AI. Det betyder att 30 % av din text uppvisar språkliga mönster som är typiska för AI-genererade texter. Skillnaden är viktig, eftersom även mänskliga texter kan visa sådana mönster.
Det här bör du göra: gå igenom de markerade avsnitten ett och ett. Formulera om avsnitt som låter påfallande jämna eller förutsägbara. Lägg till personliga exempel, fackbegrepp och egna analyser. Mer om detta finns i vår artikel om AI-detektorer och hur du kontrollerar din text.
Låt din text analyseras för AI-mönster och plagiat nu
Så säkrar du din text före inlämningen
En systematisk egenkontroll hjälper dig att hitta och åtgärda problematiska avsnitt innan din lärare granskar texten.
- Skriv själv: Använd AI för brainstorming och struktur, men formulera texten med egna ord.
- Variera din stil: Växla mellan korta och långa meningar. Använd fackbegrepp, egna bedömningar och konkreta exempel.
- Kontrollera före inlämningen: Ladda upp din text på mimir-mentor.com. Analysen kontrollerar samtidigt AI-inslag, plagiat och obelagda påståenden.
- Bearbeta markerade avsnitt: Formulera om avsnitt som är typiska för AI. Komplettera saknade källor via litteratursökningen.
- Dokumentera din AI-användning: Om du har använt AI som hjälpmedel, redovisa det i en redovisning av AI-användning. Vår guide visar hur du redovisar AI-användning korrekt.
Hur Mimirs AI-detektor skiljer sig från Turnitin och andra verktyg kan du läsa i vår jämförande artikel.
Om du efter tekniken också vill ha den praktiska bedömningen kan du läsa vidare om AI-detektorer, AI-texter på universitetet: vad är tillåtet? och att redovisa AI-texter.
Akademiska formuleringar på minuter sekunder
FAQ: vanliga frågor om hur AI-detektorer fungerar
-
Kan AI-detektorer känna igen varje AI-text?
Nej. Ingen detektor når 100 % träffsäkerhet. Tillförlitligheten beror på AI-modellen, textens längd och hur mycket texten har bearbetats. Kraftigt bearbetade AI-texter med personliga exempel och egen argumentation är betydligt svårare att känna igen.
-
Vad är skillnaden mellan perplexitet och burstiness?
Perplexitet mäter hur förutsägbara enskilda ord är: låg perplexitet betyder förutsägbart ordval, vilket är typiskt för AI. Burstiness mäter variationen i meningslängd och meningsbyggnad i hela texten. Mänskliga texter har typiskt högre burstiness än AI-genererade texter.
-
Kan AI-detektorer kontrollera svenska texter tillförlitligt?
De flesta internationella detektorer är främst tränade på engelska texter och känner igen AI-texter på andra språk, som svenska, mindre tillförlitligt. Mimir Mentor är utvecklat för akademiska texter, stöder svenska och jämför dessutom med en databas med över 200 miljoner publikationer.
-
Räcker ett resultat från en AI-detektor som bevis för vilseledande?
Nej. Goethe-Universität i Frankfurt betonar i sina riktlinjer att programvara för AI-detektering bara får användas som stöd och inte ensam räcker som bevis. Även Universität Hohenheim påpekar att det i dag inte går att tekniskt påvisa AI-användning utan tvivel. En tysk förvaltningsdomstol i Kassel har 2026 dessutom ställt upp viktiga regler för bevisningen. I Sverige avgör rektor och disciplinnämnden vid statliga lärosäten om det rör sig om vilseledande.
-
Vad är digitala vattenmärken för AI-texter?
Vattenmärken är osynliga statistiska signaturer som en AI-modell bäddar in i ordvalet när texten skapas. Den underliggande metoden beskrevs av Kirchenbauer m.fl. (2023). Samtidigt visar Sadasivan m.fl. (2023) att sådana vattenmärken kan tas bort genom parafrasering.
-
Hur undviker jag att min egen text felaktigt markeras som AI?
Variera medvetet meningarnas längd och byggnad. Använd egna bedömningar, exempel från ditt ämne och egna analyser. Undvik generiska formuleringar och standardfraser. Akademiska texter har naturligt lägre burstiness, vilket kan leda till falska positiva resultat.
-
Hur skiljer sig Mimirs AI-detektor från GPTZero eller Turnitin?
GPTZero bygger främst på perplexitet och burstiness. Turnitin använder egna neurala klassificerare och är oftast bara tillgängligt via lärosäten. Om inlämnade texter sparas beror på inställningarna för respektive uppgift. Mimir kombinerar flera metoder, är utvecklat för akademiska texter, följer GDPR och raderar dokument efter högst 30 dagar.
